
Together AI 上周(5/19)发了一份 inference benchmark,看完之后挺值得放下来想——开源推理引擎在 NVIDIA 自家的 B200 上,把 NVIDIA 自家的 TensorRT-LLM 跑赢了 31%。
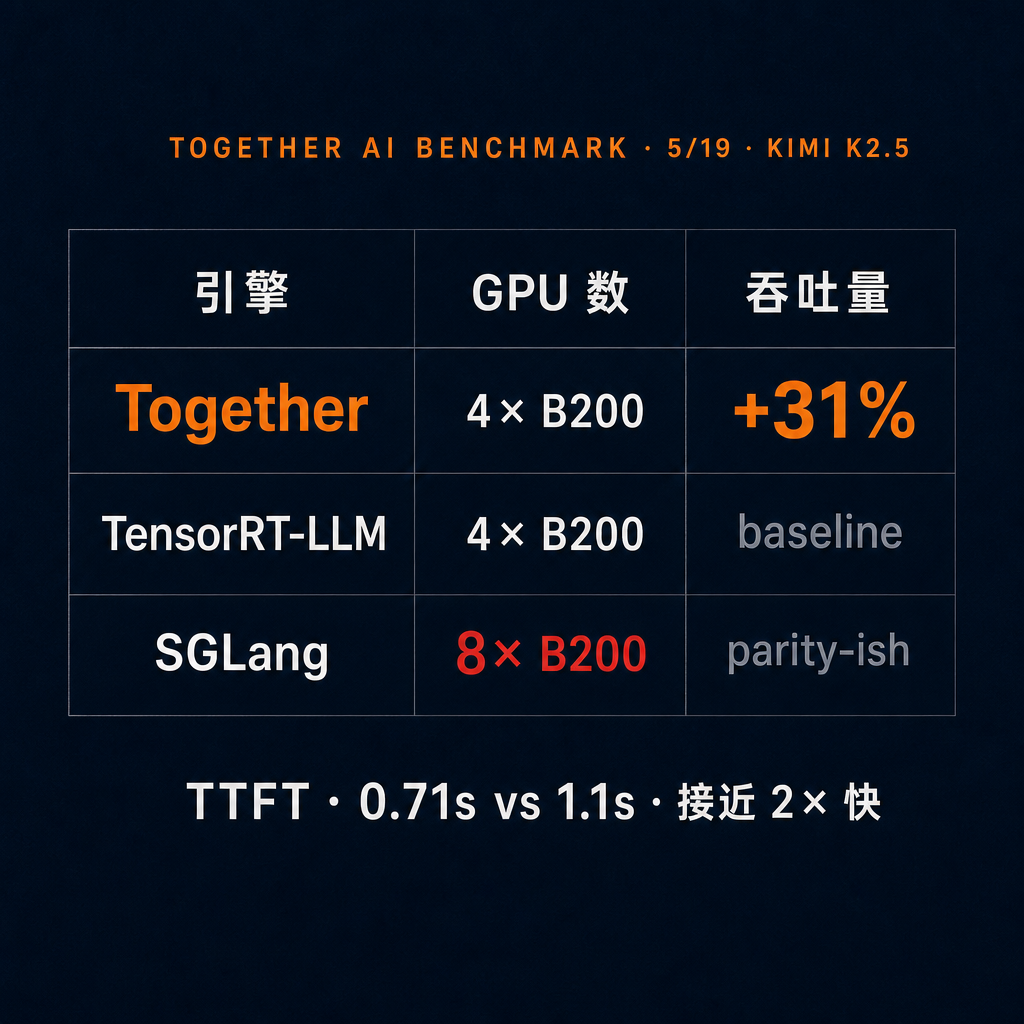
测试环境:同样 4 张 B200、同样的 Kimi K2.5 模型、同样 EAGLE speculative decoding(3 个 draft tokens)、同样 45K 到 200K token 的真实 coding agent prompt 长度。
结果——
-
Together 自家的推理引擎:每秒吞吐量比 TensorRT-LLM 高 31%
-
高并发饱和场景下的 TTFT(time-to-first-token):0.71 秒,TensorRT 是 1.1 秒,接近 2 倍快
-
第三家 SGLang:要用 8 张 B200(对方两倍硬件)才打个平手
为什么这事值得看——
NVIDIA 是芯片的设计方,理论上 TensorRT-LLM 是「最贴近硬件、最该把性能压榨到底」的那家。结果一个独立推理引擎团队,用同一台机器、同一个模型,挤出来 31% 多的吞吐——这不是边际优化,是大块的 perf 还没被官方做出来。
具体是怎么挤出来的:Together 写了一套叫 ThunderMLA 的内核、加上 EAGLE speculative decoding 的细致调度、再加上对 Kimi K2.5 这个模型本身的针对性 profiling 和 kernel rewrite。换句话说,贴着「模型 + 工作负载」深度定制内核,比贴着「硬件」做通用内核,还能多挖出来这么多空间。
放到更大的背景里看,这两年的 frontier 模型训练成本里,HBM 高带宽内存的吃比已经被推到 63%(早上那条视频讲过);compute 这条线越来越贵。在这种局面下,inference engine 这一层每挤出来 30% 的吞吐,等于在 GPU 采购预算上省掉一倍这么多——再加上 SGLang 那种 2 倍硬件才能打平的对比,inference 优化的 ROI 这两年是被严重低估的。
对正在自己 deploy LLM 或者搭 agent 集群的团队,有两个直接的 takeaway:
第一,默认就上 TensorRT 不是最优解,值得跑一遍对照,工作负载越特殊、差距通常越大。第二,inference engine 这一层正在分化,长尾的优化空间还很大,接下来一年大概率会看到更多专门贴着某一类模型(coding agent、长上下文、混合精度)做的推理引擎。
完整的 benchmark 数据 + 内核细节都在 Together 这篇博客里,链接放在第一条评论。
转给那个还在默认用 TensorRT-LLM 的朋友——也许 31% 的 perf 就藏在切换里。
报告原文 · 👇 第一条评论
关注 @svtransit1 · 写给真在用 AI 的人
#AI #Inference #LLM #Together #Kimi
原始来源:https://www.together.ai/blog/coding-agent-benchmarks
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS