
视频生成 + 交互这条线,今天有了第一个体系化的考卷。复旦 + 美团 Longcat 合作的 WBench 在 5 月 26 号挂上 arXiv,把 20 个 video world model 拉到同一张试卷上,测了 5 个维度。📐
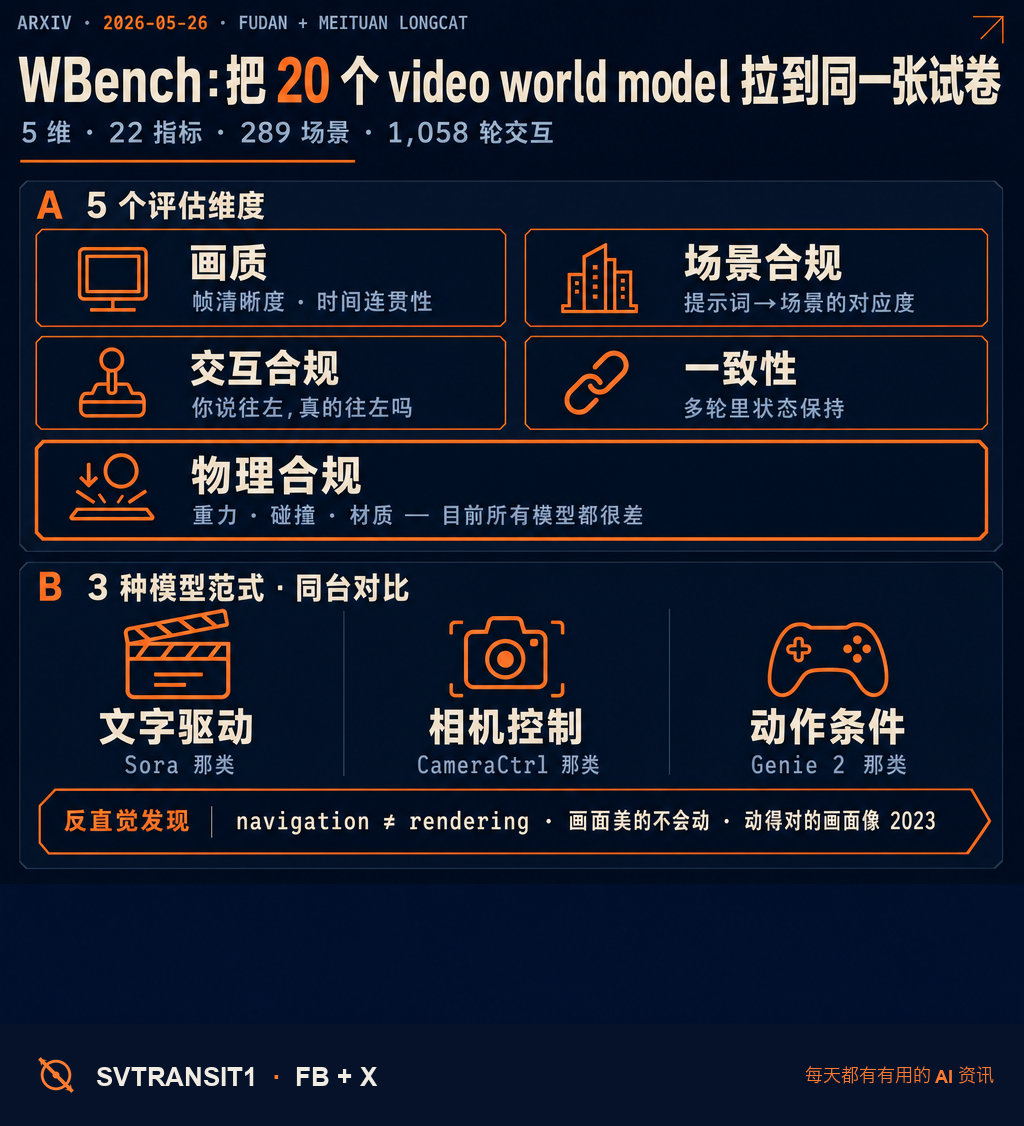
最戳人的结论:没有任何一个模型同时在 5 个维度上拿高分。视频画质做得最好的不会乖乖跟着你的操作走,操作跟得最准的画面看起来又像 2023 年的样子。
#WBench测的5个维度 🎯
1️⃣ 画质 · 帧清晰度、分辨率、时间上的连贯性
都是「这一帧看着舒不舒服」的层面。
2️⃣ 场景合规 · 给你提示词「黄昏的图书馆」,出来的真的是黄昏的图书馆吗?
家具有没有错位、光线对不对、风格连不连贯。
3️⃣ 交互合规 · 你说「往左走」,角色真的往左走吗?
按下键、鼠标拖拽、文字指令——模型听不听话。
4️⃣ 一致性 · 第一轮你把椅子挪了位置,第 8 轮椅子还在那个新位置吗?
多轮交互里状态有没有跟得上。
5️⃣ 物理合规 · 重力、碰撞、材质——苹果掉到地上会弹一下,还是穿过桌子?
这一项目前所有模型都很差。
22 个细分指标、289 组测试场景、1,058 轮交互——基本上是 Sora 之后第一份能让大家拉到同一个表里比较的 video world model 基准。📊
#测了哪些模型
WBench 拉了 20 个模型,分成 3 个范式:
🎬 文字驱动 · Sora 那一类,你写提示词模型生成视频
🎥 相机控制 · CameraCtrl 那一类,你给镜头位姿模型按指令运镜
🎮 动作条件 · Genie 2 那一类,你给离散动作模型实时响应
最有意思的设计:WBench 提供了一个统一的导航接口,让 3 种范式的 20 个模型可以丢到同一组测试里比较——以前是「我家的 score 最高」各说各话,现在大家用同一把尺。📏
#一个反直觉的发现 💡
模型的 navigation 能力 ≠ rendering 能力——这两件事在不同模型身上是解耦的。
意思是:你看到一个 demo 视频画面华丽,不代表它能跟你互动;你看到一个模型「我让它做啥就做啥」,不代表画面就好看。一个会做事的视频模型,跟一个会拍片的视频模型,目前根本不是同一群。
这条 insight 对接下来一年的产品决策很重要——做游戏 / 仿真 / 机器人训练的团队,不能只看 demo 美不美,得看「multi-turn 状态一致性」这条线。
📦 GitHub · HF dataset · arXiv 论文 · 👇 第一条评论
关注 @svtransit1 · 写给真在用 AI 的人
#AI #VideoWorldModel #benchmark #Fudan #Meituan #硅谷中转站
原始来源:https://arxiv.org/html/2605.25874
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS