
视觉-语言模型这条线今天又被上一个台阶。👁️ LLaVA-OneVision-2 在 arXiv 上挂了——943 个点赞,是今天 HF 论文版面里票数最高的一篇,把开源 8B 多模态的天花板往上抬了一截。
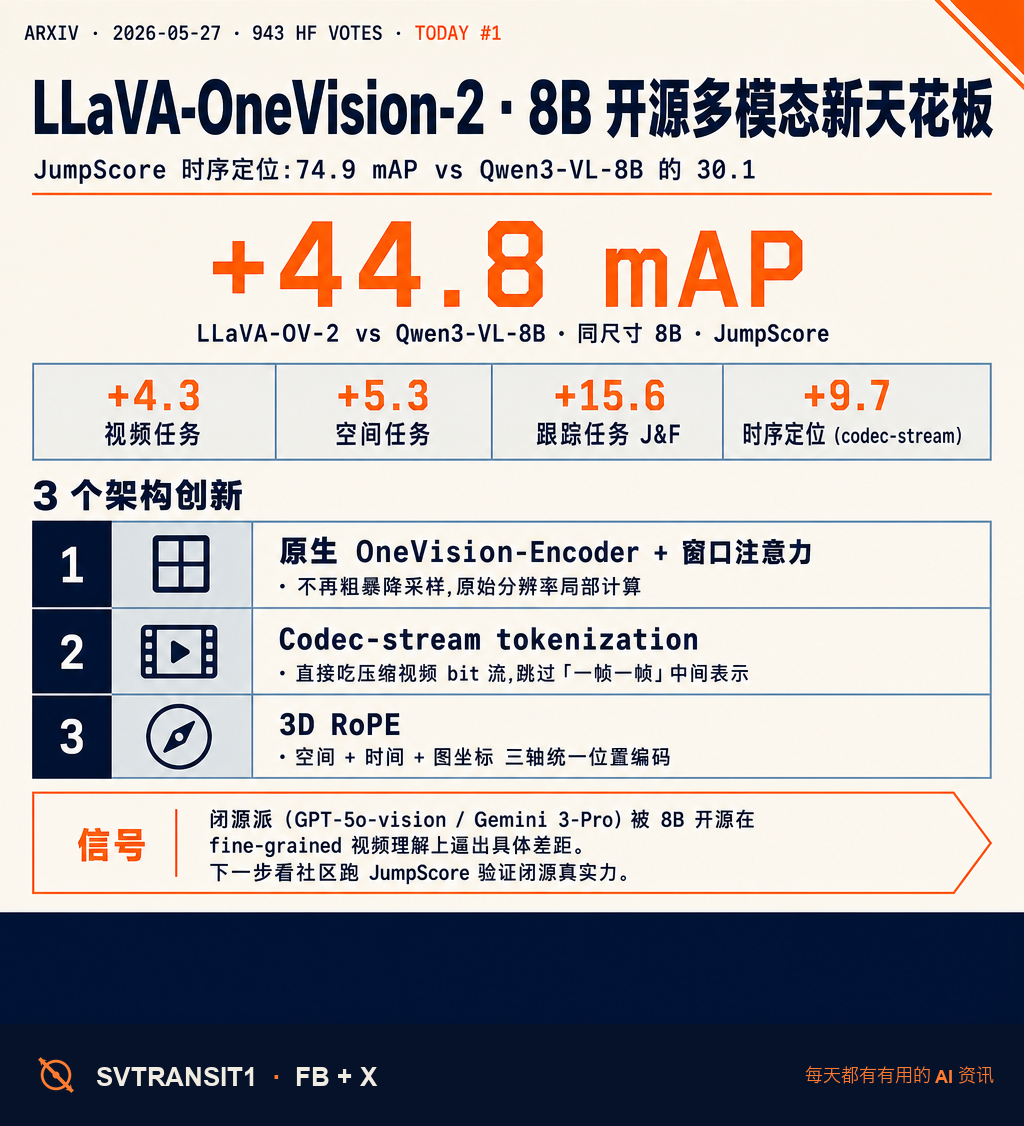
最戳人的数字:在一个全新的「JumpScore」时序定位基准上,LLaVA-OV-2 的 8B 模型拿了 74.9 mAP,同级别 Qwen3-VL-8B 只有 30.1。差 44.8 个点。这是「比 Qwen3-VL-8B 强一倍」量级的差距——同样的 8B 参数,完全不同的能力轮廓。
#为什么这次差距这么大 🎯
不是模型大小堆出来的——两边都是 8B。差距主要来自三个新的架构动作:
1️⃣ 原生 OneVision-Encoder + 窗口注意力 — 不再粗暴降采样,直接在原始分辨率做局部计算。视觉细节没被压扁,温度细微的运动也能保住。
2️⃣ Codec-stream tokenization — 直接把压缩视频的 bit-cost 流当成 token,跳过「一帧一帧的图」这个中间表示。运动剧烈的位置自动多放几个 token,静止的位置少放——比固定 GOP 切分省得多,而且抓时序更准。单这一项就给时序定位加了 +9.7 分。这个想法其实借用了视频压缩学界几十年的智慧——压缩算法本来就把「哪里在动」这个信号编进了 bit 分布里,只是过去多模态模型一直没去用它。
3️⃣ 3D RoPE — 把空间坐标、时间轴、和静态图坐标系统一编码到一个三维位置编码里。视频、单帧、图片在同一个表征空间里被理解,不需要分管道。
#这个 JumpScore 基准本身也是大动作 🪧
之前的视频理解 benchmark,大多停留在「动得不快的镜头里能不能说清楚发生了什么」。但真实视频里大量场景是「高频反复的运动」——体育、操作演示、跳剪。LLaVA-OV-2 团队建了 JumpScore 专门测这条「快速反复运动里能不能精确时间定位」的能力,然后顺手把这条线拉到 74.9 mAP。
简化讲就是:他们做了一个新尺子,然后告诉世界——我们家在这把尺上比所有人都高一截。这种「自定义 benchmark + 自家模型登顶」的做法本来容易让人怀疑,但 OneVision-2 同时在已有的视频 / 空间 / 跟踪基准上分别 +4.3 / +5.3 / +15.6 J&F,所以并不是只在新基准上偷分。
#为什么 AI builder 该读一下 🛠️
📊 训练数据规模:8M 重新打标的视频样本 + 4M 空间数据语料
🌏 30 人作者团队 (Xiang An / Yin Xie / Feilong Tang 等),典型开源 LLaVA 家族风格
🔗 LLaVA 系列一般会跟着发权重、代码、训练 recipe——这意味着任何想跑视频 agent / 操作回放 / 物理交互推理的团队,下周就能拿到 8B 级别的新基线
🎯 在已有的视频 / 空间 / 跟踪基准上分别 +4.3 / +5.3 / +15.6 J&F——这条线不是只在自家 benchmark 上偷分
更深一层的信号:多模态模型这一年的瓶颈从「能不能看懂图」转到「能不能在视频时间轴上精确定位行为」——这是机器人、监控、自动驾驶、内容审核共同的需要。LLaVA-OV-2 这次把开源天花板抬到了这条线上。
闭源派 (GPT-5o-vision、Gemini 3-Pro 那些) 在 fine-grained 视频理解这条线上,现在被一个 8B 开源模型逼出了具体的差距。下一步要看的是闭源方会不会公开各自在 JumpScore 上的分数——他们大概率不会,但社区会用 Hugging Face 上的开源接口跑出来。这条线的「真实力对比」很快就会被外部研究者补上。
🔭 arXiv 全文 + JumpScore benchmark + 完整作者列表 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #多模态 #LLaVA #开源模型 #arxiv #硅谷中转站
原始来源:https://arxiv.org/abs/2605.25979
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS