
一个 11 个人的巴黎小团队说,标准 GPU 上单条请求能跑到每秒 3000 个 token。先别急着兴奋,也别急着划走——这数字背后的门道,比数字本身有意思。🏎️
这家叫 Kog 的 AI 基建初创放了个技术预览:8 张 AMD MI300X 上单请求 3000 tok/s,8 张 H200 上 2100,FP16,没用投机解码。但有个前提得先摆上桌:跑的是一个 2B 的 dense 小模型、batch=1、4096 上下文。所以别误读成「连大模型也能这么快」——它真正证明的,是在这个特定配置下,他们把系统开销榨得特别干。
先说清楚他们对症下药的那个判断:大模型在生成(decode)阶段,卡脖子的是显存带宽,不是算力。每吐一个 token,都得把整个模型的权重从显存完整读一遍——2B 模型 FP16 就是约 4GB 反复搬。你的速度上限基本是「显存带宽 ÷ 模型大小」这道除法,算力再高,权重搬不过来也是空转。对语音助手、实时 agent 这种一次只服务一个人、没法靠堆 batch 摊薄的场景,单流速度尤其要命。
冲着「省时间」,他们出了三招:
1️⃣ Monokernel。一般框架 decode 走一步要启动几十上百个小 GPU kernel,每次启动、每次回主机调度都在烧微秒。Kog 把整条 decode 路径塞进一个常驻的单一大 kernel,边界开销直接抹掉。
2️⃣ 自研通信库 KCCL。多卡之间做 AllReduce 同步,厂商现成的库大概 8 微秒一次;他们手写到汇编层、按架构调,压到 3 微秒以内。
3️⃣ Delayed Tensor Parallelism。把多卡并行的依赖关系重排,让卡间通信「藏」在计算背后跑,而不是堵在关键路径上干等。
三招叠起来,显存带宽利用率(MBU)大概做到 36%——全程没量化、没投机解码、没剪枝、没压 KV cache。
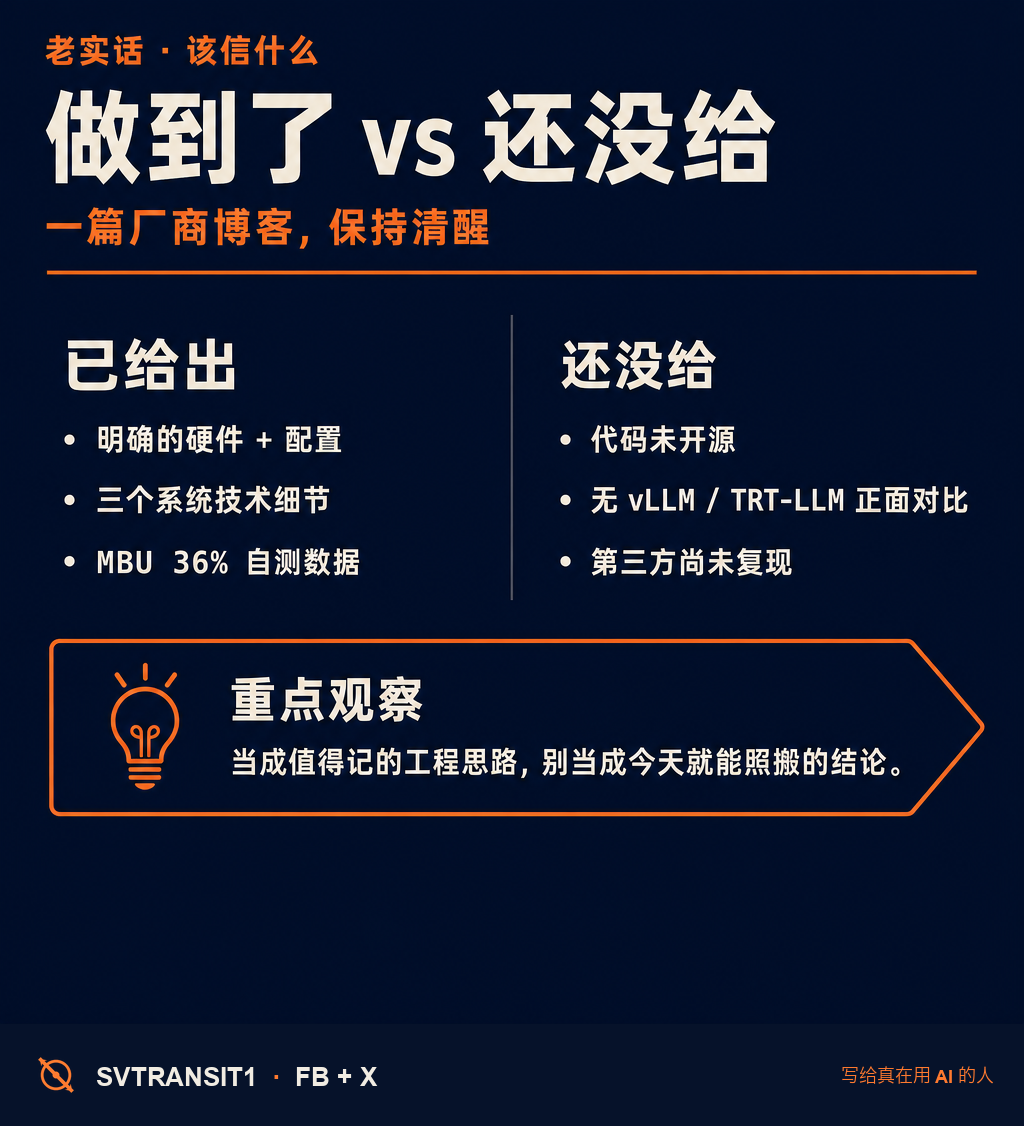
老实讲,这是厂商自己的博客:代码不开源,没给跟 vLLM、TensorRT-LLM 的正面对比,2B + batch=1 的数字也很难直接套到你的生产负载上,第三方还没复现。所以我把它当成一个值得记住的工程思路,而不是一个今天就能照搬的结论。
但那句核心判断是真的,也最该带走:LLM 推理的 decode 阶段,是显存带宽的游戏,不是算力的游戏。
你部署本地模型挑卡时,盯的是 GPU 算力(TFLOPS),还是显存带宽?
🏎️ Kog 原文:3000 tok/s 的系统拆解 + 完整前提 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #LLM推理 #GPU #本地部署
原始来源:https://blog.kog.ai/real-time-llm-inference-on-standard-gpus-3-000-tokens-s-per-request/
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS