
【原来......很多人都不知道 6G 显存就能跑 35B 级开源模型 + 接 Agent?】🧱⚡
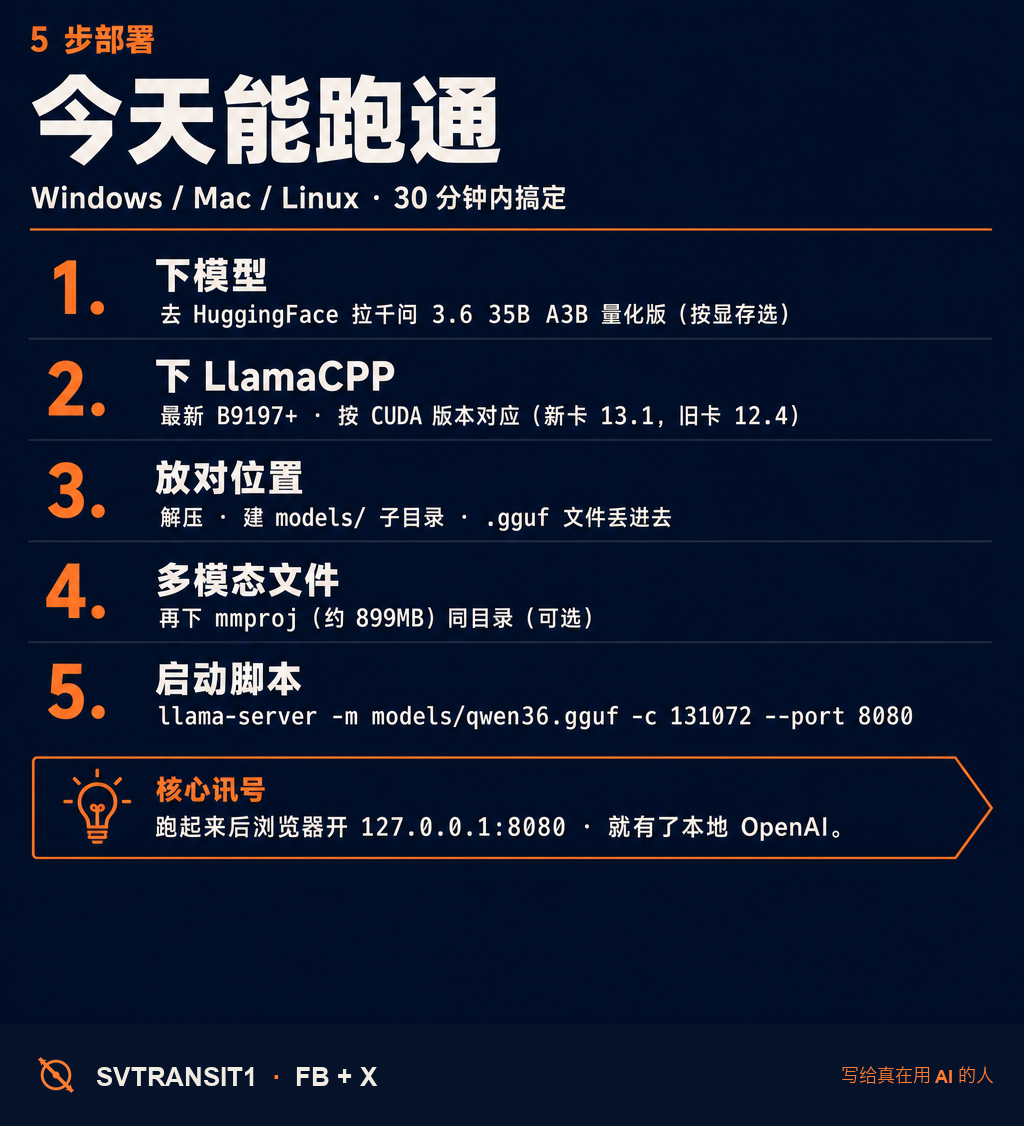
很多人一看到 35B 这种参数级别, 第一反应是「至少要 24G 显存的 4090 才能跑」。零度解说昨天发了一支教程把这个认知翻过来 — 千问 3.6 的 35B A3B 模型, 配上 LlamaCPP 最新版 + 激进量化, 6G 显存就能本地跑起来, 再接 Agent 闭环。
千问 3.6 的 35B A3B 在 Artificial Analysis 排行榜上, 中文理解、代码能力、多模态视觉、长上下文、推理 — 在 40B 以内开源模型里几乎全是榜首。这次 LlamaCPP 团队还做了多种量化板, 把它压到 6G 也能跑。
它实际能帮你做什么:
① 本地推理场景
-
Chat / coding / 多模态分析, 全离线, 数据不出本机
-
N 卡 (10/20/30/40/50 系)、A 卡、Intel 显卡全支持
-
6G 显存跑 IQ1_M 量化版, 16G 跑 IQ3 量化版, 24G 跑 Q4_K_M / Q4_K_P
-
实测速度: 24G 卡上 Q4_K_P 约 25 token/s, 平衡版能跑到 80 token/s
② 本地 Agent 场景
-
LlamaCPP 起的服务就是标准 OpenAI 兼容接口 (127.0.0.1:8080)
-
任何支持自定义 OpenAI endpoint 的客户端都能直接接 (Cherry Studio, AnythingLLM 等)
-
不限 Token, 不收 API 费, 真正的本地 AI 自由
⚙ 5 步本地跑通:
1 · 去 Hugging Face 拉千问 3.6 35B A3B 量化版 (按你的显存挑: 6G→IQ1_M, 16G→IQ3_M, 24G→Q4_K_M)
2 · 下 LlamaCPP 最新版 (B9197+, Windows / Mac / Linux 都有, 按 CUDA 版本对应: 30/40/50 系选 CUDA 13.1, 旧卡选 CUDA 12.4)
3 · 解压, 建 models/ 子目录, 把刚下的 .gguf 文件丢进去
4 · 如果要用多模态视觉, 再下一个配套的 mmproj 文件 (约 899MB) 放同目录
5 · 写一个简单的 .bat / .sh 启动脚本 (llama-server -m models/qwen36.gguf -c 131072 –port 8080), 跑起来后浏览器开 http://127.0.0.1:8080
Agent 接入这步是关键 (零度解说视频里没细讲但是值得拎出来说):
把 LlamaCPP 当成你的「本地 OpenAI」, 任何 agent 工具都能接。Cherry Studio 选「自定义 OpenAI」provider, base URL 填 http://127.0.0.1:8080/v1, API Key 随便填一个字符串 (本地不验证), 模型名填你下载的 .gguf 名字, 上下文长度填 131072 (千问 3.6 的最大 context)。
实测 agent 工作流跑得动: 让它去抓今日 AI 新闻热点, 它会调浏览工具实际爬取 + 总结。这条流程跑通, 就基本不需要再为 token 账单写脚本省钱了。
更大的信号: 2025-2026 这一波的开源 35B 级模型, 性能已经摸到去年 GPT-4 / Claude 3 那个水位线。配上 LlamaCPP 这种贴近裸金属的量化推理框架, 本地跑 frontier-tier 模型这条路终于走得通。下一年「本地 AI 自由」会从极客玩具变成开发者标配。
P.S. 数据不出本机这点对企业自托管、医疗、法律、金融场景特别重要。完整教程视频是零度解说做的, 中文界面 + 详细操作步骤, 适合第一次本地部署的人参考。
转给那个还在为 35B 模型升级显卡的工程师朋友 👇
关注 @svtransit1 · 写给真在用 AI 的人
🧱 千问 3.6 官方 HF 链接 + LlamaCPP 最新版 + 零度解说原视频教程 · 评论区取 ↓
#Qwen #LlamaCPP #本地LLM #AIagent #开源
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS