
换不换主力模型,先别盯着榜单分数,盯着你月底那张 API 账单。💸
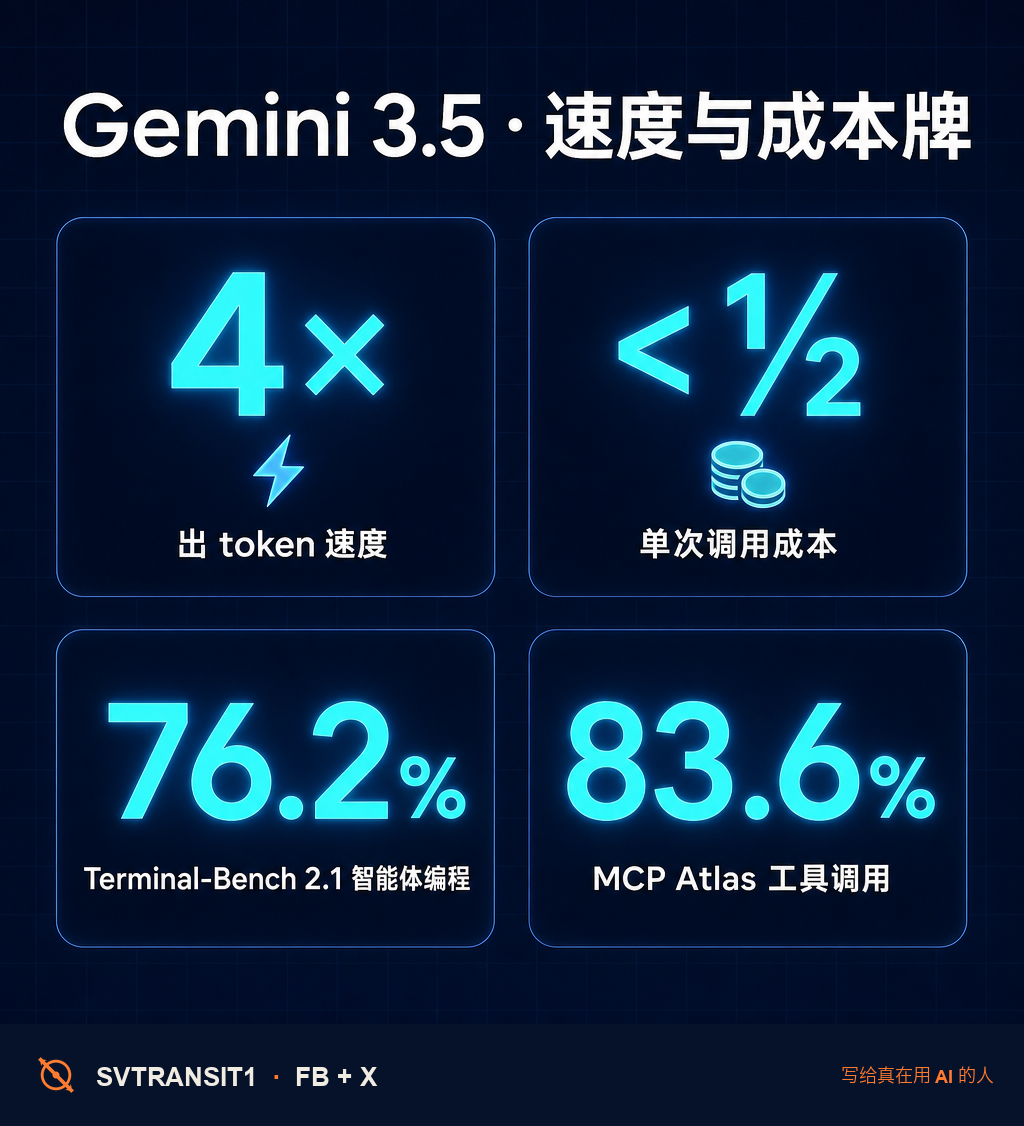
Google 刚把 Gemini 3.5 摆上桌,卖点很直接:同档前沿水平,出 token 快四倍、价格便宜一半。它没怎么在「我更聪明」上做文章,反倒把宝几乎全押在了速度和成本这两件事上。对偶尔问两句的人这没差;但对一天到晚开 agent loop、token 哗哗烧的人,这恰恰是真正要紧的那根轴。⚡
为什么这两个数对跑 agent 的人这么关键?想想一个稍微复杂点的任务:agent 自己规划、调工具、读结果、再决定下一步,背后是几十上百次模型调用,token 一轮一轮地烧。在这种场景里,一个分数差一两分、但速度快四倍、单价便宜一半的模型,折算到端到端的体验和账单上,反而可能更顺手。榜单上那两三分,跟你月底账单上的那串零比,谁更重要还真不一定。
按 Google 自己给的数,几条轴摆一摆 👇
🏎️ 速度 —— 出 token 的速度是其它前沿模型的四倍。注意措辞:是「出 token」的速度,不是你那个任务端到端就快四倍,中间还卡着工具调用、网络往返、你自己 agent 框架的开销。
💰 成本 —— 常常只要别家前沿模型的一半多一点点,跑大批量任务时,这是实打实省下来的真金白银。
🧰 agentic —— Terminal-Bench 2.1 拿了 76.2%(模型自己操作终端、把一个真实任务从头跑通),MCP Atlas 83.6%(调工具那一整套)。Google 直接把它定位成「目前最强的 agentic 和 coding 模型」。
📊 多模态 —— CharXiv Reasoning 84.2%,外加一个偏真实经济任务的 GDPval-AA,报了 1656 Elo。看图表、读文档这类活也没落下。
🔌 生态 —— 它专门报了 MCP 的分。MCP 是 Anthropic 先推的工具协议,现在 Google 也认真接进来当卖点,说白了就是大家在往同一套接口上收敛。对用 Claude Code、挂一堆 MCP server 的人是好事:以后想换底层模型,工具那一层不用全部重写。
该泼的冷水也得泼一句:这些数字全是 Google 自己测、自己报的,换个评测集、换个 prompt 模板、把任务难度往上调一档,76.2 晃一晃太正常。🧐 先把它当成「值得去验证的方向」,别当成结论。
那到底谁该用哪个?
· 写 demo、偶尔问两句的 → 留在你现在顺手那个就行,别折腾。
· 跑大规模 agent、月底账单看着肉疼的 → 值得认真试一轮。拿一个你跑熟了的真实任务,同样的 prompt 在新旧模型上各跑十遍,就比三个数:成功率、平均耗时、烧掉多少钱。这三个摆一起,比任何官方榜单都更能告诉你该不该换。
它现在能在 Gemini API、Android Studio 和企业线上用,Google 也把它跟自家的 Antigravity 多 agent 平台绑在了一起。
转给那个正在为 agent 账单头疼的同事。👇
关注 @svtransit1 · 写给真在用 AI 的人
链接 · 👇 第一条评论
#AI #Gemini #AIagent #AI工具
原始来源:https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-5/
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS