
今天早些时候那条还记得吗:有公司一个月在云上烧掉 5 亿美元跑 Claude。同一天,Liquid AI 扔出一个 8B 模型,在你自己的笔记本上、纯 CPU 就能跑到 253 tokens/秒。🤯
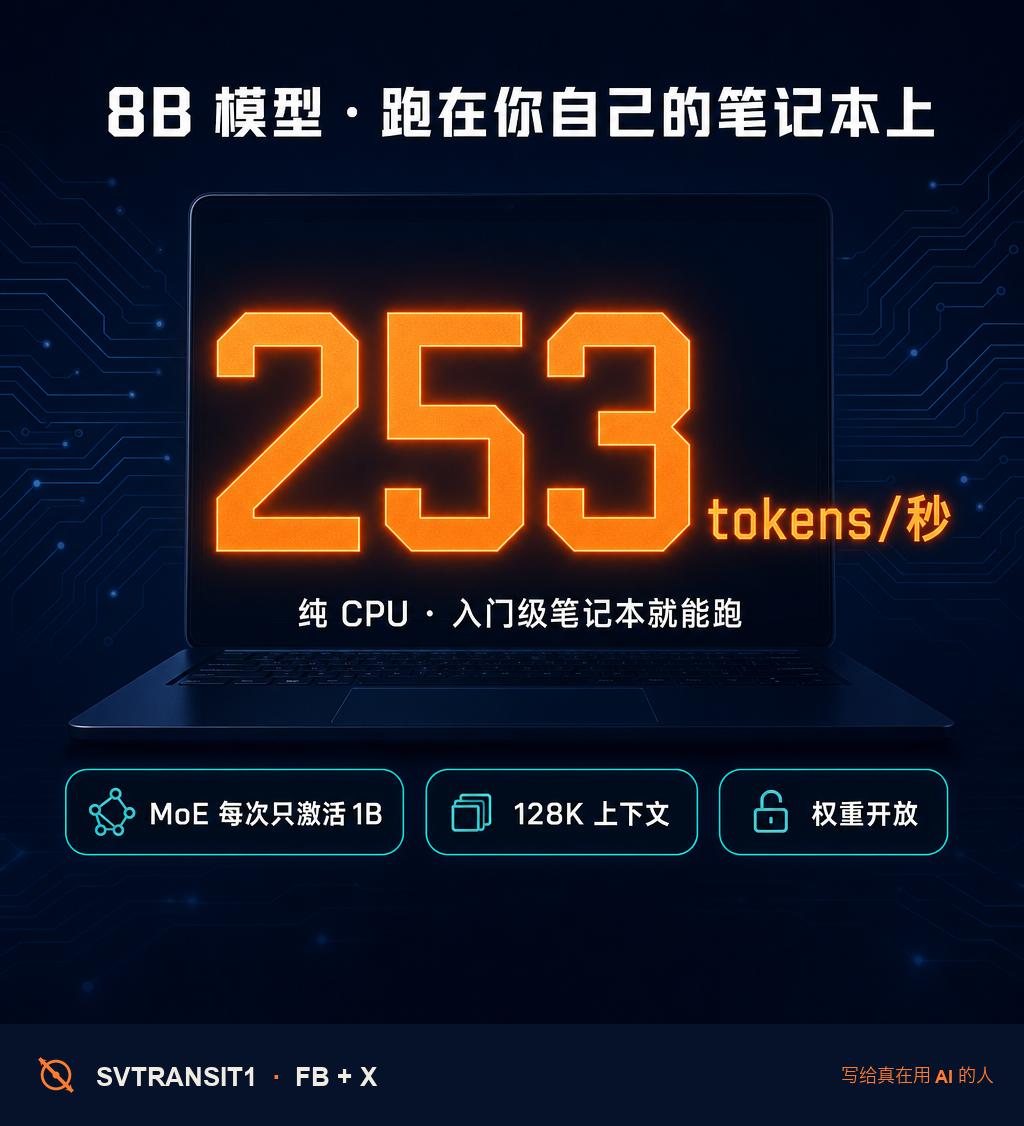
这个模型叫 LFM2.5-8B-A1B。名字拗口,关键就两点:8B 总参数,但每次只激活 1B(MoE),所以小机器也扛得住;预训练用了 38 万亿 tokens,上下文从上一代的 32K 直接拉到 128K,还带了 reasoning(先想再答)和工具调用。
几个数感受一下:M5 Max 的 CPU 上 253 tokens/秒,Ryzen AI Max+ 是 146,放到 H100 上 1.85 万/秒。官方说它「能在入门级笔记本上舒服地跑」。分数也不虚:IFEval 91.84、MATH500 88.76、工具调用 BFCLv3 64.79。
有个数得说清楚、别神化:它在一个很硬的知识基准 AA-Omniscience 上,「非幻觉率」是 63.47%——指它不胡编的比例,比上一代明显提升,但不等于「它不会幻觉」。本地小模型,事实性这块还是得自己留个心眼。
权重已经开放,HF 上能下,llama.cpp、MLX、vLLM、SGLang 都能跑。🛠️
老实说,要论最强,云端那条路现在还是赢。但「一个 8B,在自己笔记本上能想、能调工具、还能啃 128K 上下文」这件事本身,指向的是另一条路:不是所有 AI 任务,都得跑在别人的账单上。
转给那个总说「本地模型没法用、还是得上云」的朋友。👇
关注 @svtransit1 · 写给真在用 AI 的人
🔗 Liquid AI 模型卡 · 第一条评论取 ↓
#AI #本地LLM #开源模型 #MoE
原始来源:https://www.liquid.ai/blog/lfm2-5-8b-a1b
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS