
LocateAnything-3B · NVIDIA 这周开源的视觉定位小模型,5 个点看懂它为什么值得关注 👇
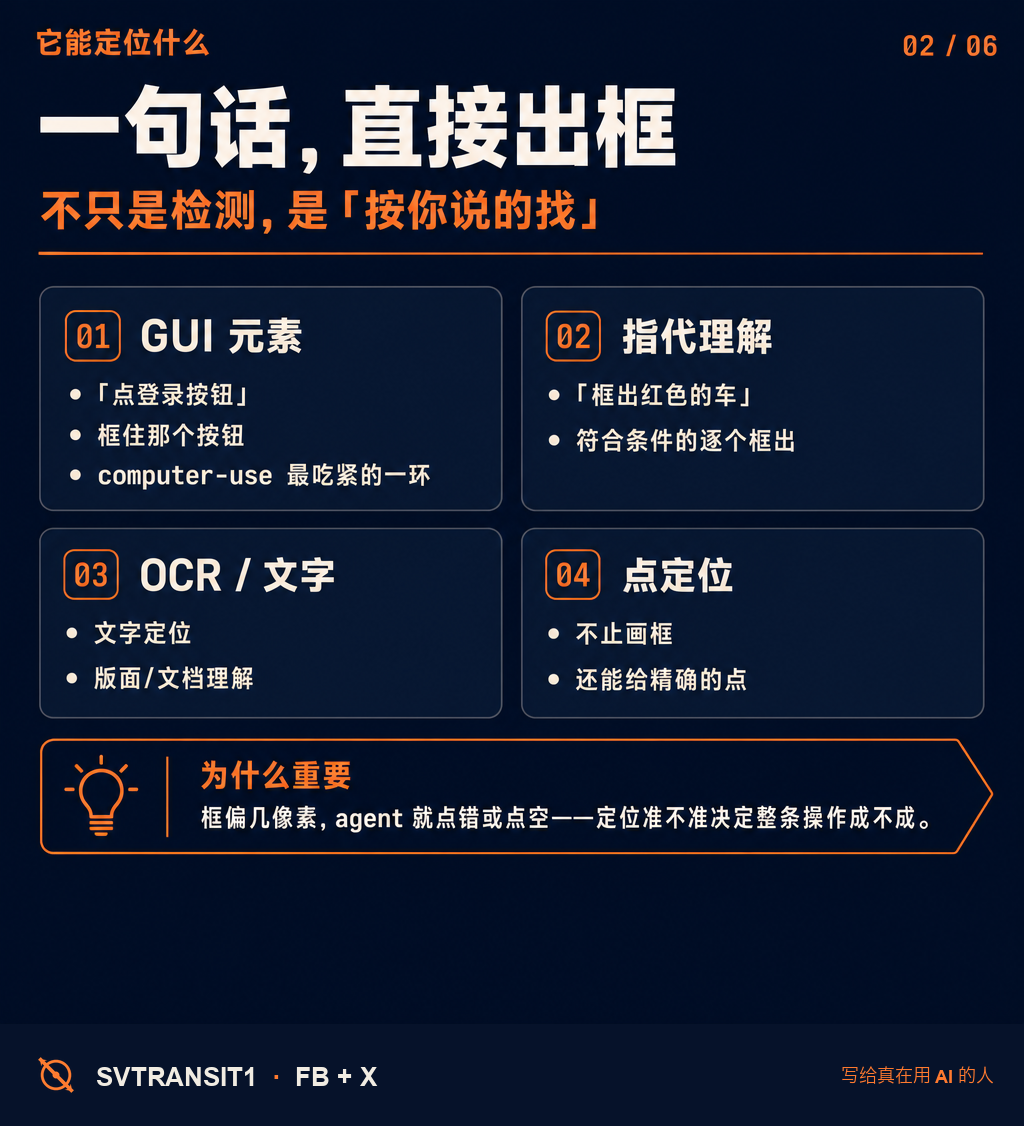
先说它戳的痛点:让 AI 帮你点屏幕,最难的从来不是「点」,是「看准点哪」。这一步叫 visual grounding(视觉定位),做不准,后面再聪明的操作也白搭。这两年那些「computer use / 操作电脑」的 agent,卡的常常就在这儿——模型脑子够用,可一到「在这屏上把那个东西指出来」就飘。LocateAnything 想啃的正是这块硬骨头。
1️⃣ 它干的活很具体
你给一句话,它直接吐出一个精确的框。「点登录按钮」→ 框住那个按钮;「框出所有红色的车」→ 一辆辆都框出来。OCR、文字定位、指代理解、点定位也都能干。🎯 别小看「精确」两个字:框偏几个像素,agent 就可能点到旁边那个按钮,或者干脆点空——定位准不准,直接决定后面整条操作成不成。
2️⃣ 不只是 GUI
自然场景、机器人、驾驶、文档它全喂过。训练数据是 1200 万张图、1.38 亿条自然语言 query、7.85 亿个 bounding box——一个见过世面的「找东西」专家。NVIDIA 这次还特别强调了屏幕/GUI 这一类场景,正好对上 agent 操作软件最吃紧的那一环。
3️⃣ 速度的诀窍叫 Parallel Box Decoding
以前这类模型生成框的坐标,是一个数字一个数字地自回归往外蹦,框越多、越慢。它换了思路:一步把整个框的坐标并行预测出来,框再多也不会一路拖下去,吞吐量最高快 2.5 倍。⚡ 对那种要连续操作、一秒扫好几屏的 agent,这个快是实打实省时间的。
4️⃣ 小,而且开放
3B 参数,底座是 Qwen2.5-3B 加一个 MoonViT 视觉编码器。权重已经放出来了(Safetensors BF16),HF 上还挂了个 demo——传张图、写句话,就能看它框得准不准,不用先折腾环境。
5️⃣ 一句冷水:仅限非商用
它走的是 NVIDIA license,学术和研究随便用;想塞进自己产品里卖钱——这条路它没给你开。🧐 所以现在更适合拿来研究、验证想法,先别急着上生产。
收个尾:agent 想真的能用,光会「想」不够,得先能「看准」。把视觉定位单独做扎实的这种小模型,可能比又憋一个更大的通用模型,更接近「AI 真能帮你操作屏幕」那一天。
你觉得 AI 操作 GUI,卡点是在「看」,还是在「想」?
关注 @svtransit1 · 写给真在用 AI 的人
🤗 HF 模型卡 + 论文 · 评论区取 ↓
#AI #多模态 #AIagent #开源模型
原始来源:https://huggingface.co/nvidia/LocateAnything-3B
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS