
【原来开源 TTS 已经能「几句话克隆一个声音」了?】
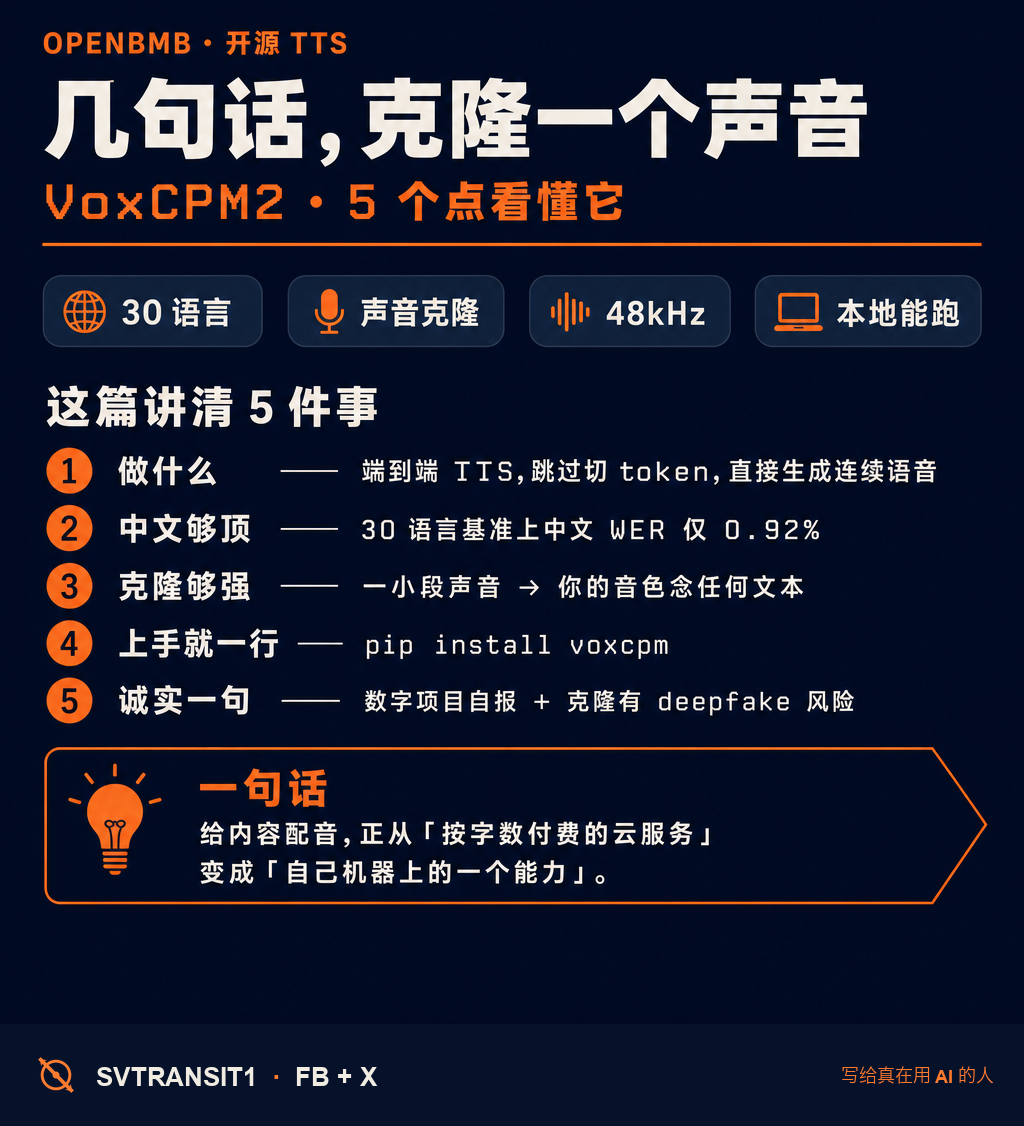
想给视频、播客、或自己做的 app 配一个「像真人」的旁白,过去要么花钱买 API,要么效果一听就出戏。OpenBMB 这两天开源的 VoxCPM2,把门槛压低了不少——而且对中文特别友好。🎙️
它是个 TTS(文字转语音)模型,但路子有点不一样:跳过了「把语音切成一个个 token 再拼」这步,端到端直接生成连续语音,出来是 48kHz 的录音棚级音质。
两个最能打的点:
🀄 中文够顶:支持 30 种语言、还不用打语言标签;在自家 30 语言基准上,中文字错率(WER)只有 0.92%。说人话——基本就是一百个字里读错不到一个,中文 TTS 最容易翻车的多音字、数字、英文夹中文,它处理得算稳。对做中文内容的人,这个数很关键。
🎭 克隆够强:给一小段你的声音,它就能用你的音色念任何文本;想更像,再配上那段音频的文字稿(Ultimate Cloning);连参考音都不想录,它还能直接「设计」一个音色出来。
⚙ 上手很简单:先 pip install voxcpm(Python 3.10–3.12 / PyTorch ≥2.5 / CUDA ≥12);然后几行 Python——from voxcpm import VoxCPM,再 model.generate(text=…) 就出音频;Apache-2.0、权重开放、能本地跑,你的声音不用传到别人服务器上。
速度也够用:RTX 4090 上 RTF≈0.30(比实时快三倍多),配 Nano-vLLM 到 0.13,实时配音、对话都扛得住。
能拿它干嘛?几个最直接的:
・给视频 / Reels / 短片配旁白——一个固定音色,整条片子统一,不用一句句配音
・做播客或有声读物——把文字稿直接读成音频,改稿了重生成一遍就行
・给自己的 app 加语音——本地跑,不用按字数给云服务交钱、也不用把用户数据外传
・做个「数字分身」——用自己的声音念脚本,人不在也能「开口」
P.S. 它那个不用参考音的「Voice Design」挺有意思:你不必有现成录音,直接描述想要的音色它就能造一个出来;30 种语言里除了中英,日、韩、法、德、西、阿拉伯这些也都在。
记一个心法:本地 + 开源 + 能克隆,意味着「给内容配音」这件事,正在从「按字数付费的云服务」,慢慢变成「自己机器上随便跑的一个能力」。对天天产内容的人,这不只是省钱,更是把「声音」这块也攥回了自己手里——想改就改、想跑多少跑多少,不看别人 API 的脸色。
⚠ 但得说两句实在话。一,WER 和速度都是项目自报、在 4090 上测的,你的机器和素材不一定跑出一样的数。二,也更重要——「几句话克隆一个声音」是把双刃剑,deepfake、冒充别人声音的风险真实存在。自己玩、给自己内容配音没问题;想用别人的声音,先拿到人家同意,做克隆内容也最好标一句「AI 合成」。🧐
转给那个做视频 / 播客、还在为旁白发愁的朋友。👇
关注 @svtransit1 · 写给真在用 AI 的人
🐙 VoxCPM GitHub 仓库 · 第一条评论取 ↓
#AI #TTS #语音克隆 #开源模型 #AI配音
原始来源:https://github.com/OpenBMB/VoxCPM
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS