
一颗 2016 年的旧 Xeon,没插任何显卡,把 Google 今年 4 月才发的 Gemma 4 26B 给跑起来了。😳
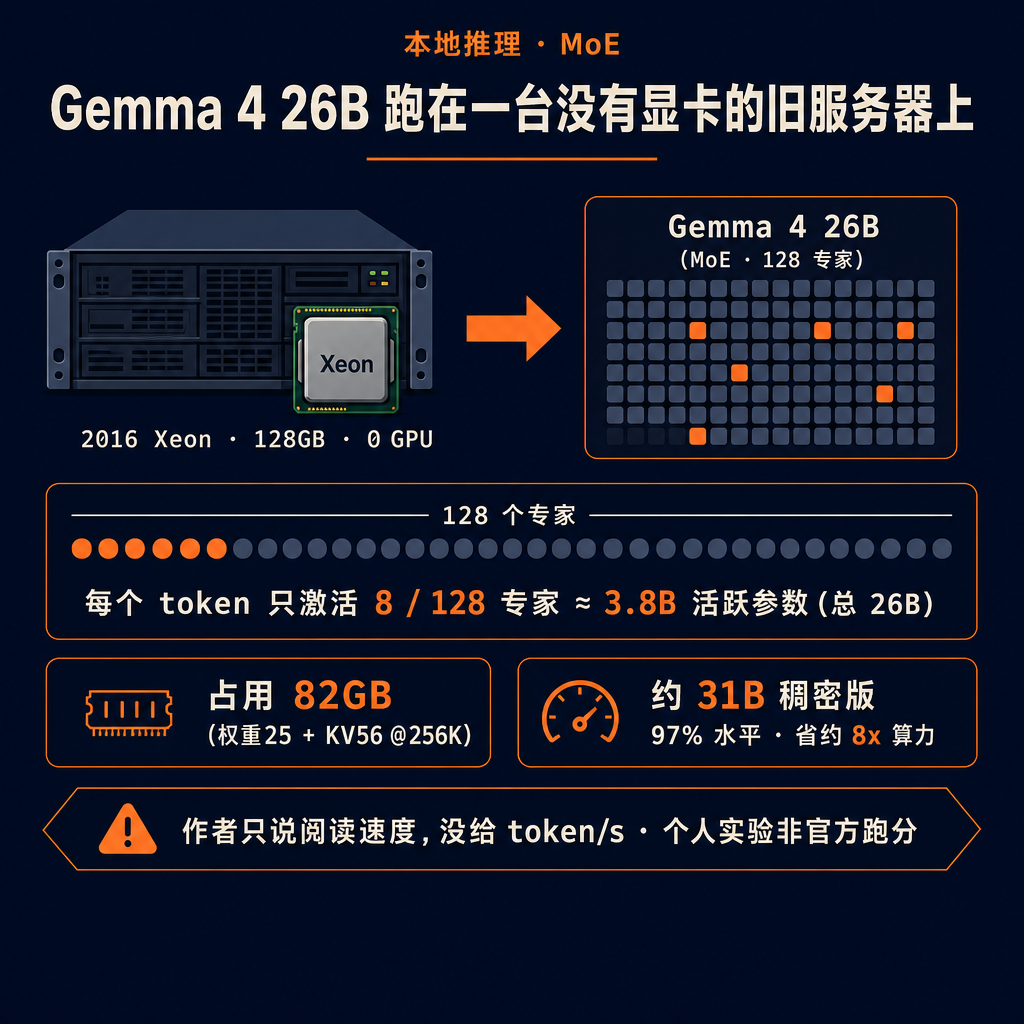
有个开发者(cafkafk)把官方模型量化成 Q8 的 GGUF,扔进一台 Xeon E5-2620 v4、128GB 内存的老机器,零 GPU。整个加载下来占 82GB——模型权重 25GB,剩下 56GB 全是 256K 超长上下文的 KV cache。
听着离谱,但有道理。Gemma 4 26B 是 MoE 架构:128 个专家,每个 token 只激活 8 个,真正动用的参数大概 3.8B。Google 自己说,它能拿到 31B 稠密版约 97% 的水平,算力却省了差不多 8 倍。它「大」在总参数,「轻」在每次只点亮一小撮——CPU 也就扛得住了。
⚠ 但得泼盆冷水:作者只说「能到阅读速度」,全程没给一个 token/s 的数字,这是他个人跑的,不是官方 benchmark。能跑通,跟跑得爽,是两回事。🧐
方向倒挺清楚:MoE 正在把「大模型」和「得有大显卡」这两件事拆开。家里吃灰的旧服务器、纯 CPU 的老机器,可能又有活干了。
你手上有没有一台闲置的老机器,想拿来跑本地模型?
原始出处 · 评论区 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #本地LLM #Gemma #MoE #边缘计算
原始来源:https://point.free/blog/gemma-4-on-a-2016-xeon/
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS