
写过爬虫的都懂这个痛:网站一改版,你辛苦写的选择器集体阵亡,脚本第二天就报废。🕷️ GitHub 上一个叫 Scrapling 的框架(57.6k star,BSD 协议)想治这个老毛病,顺手还把 AI agent 也照顾到了。挑四个真有意思的点说说:
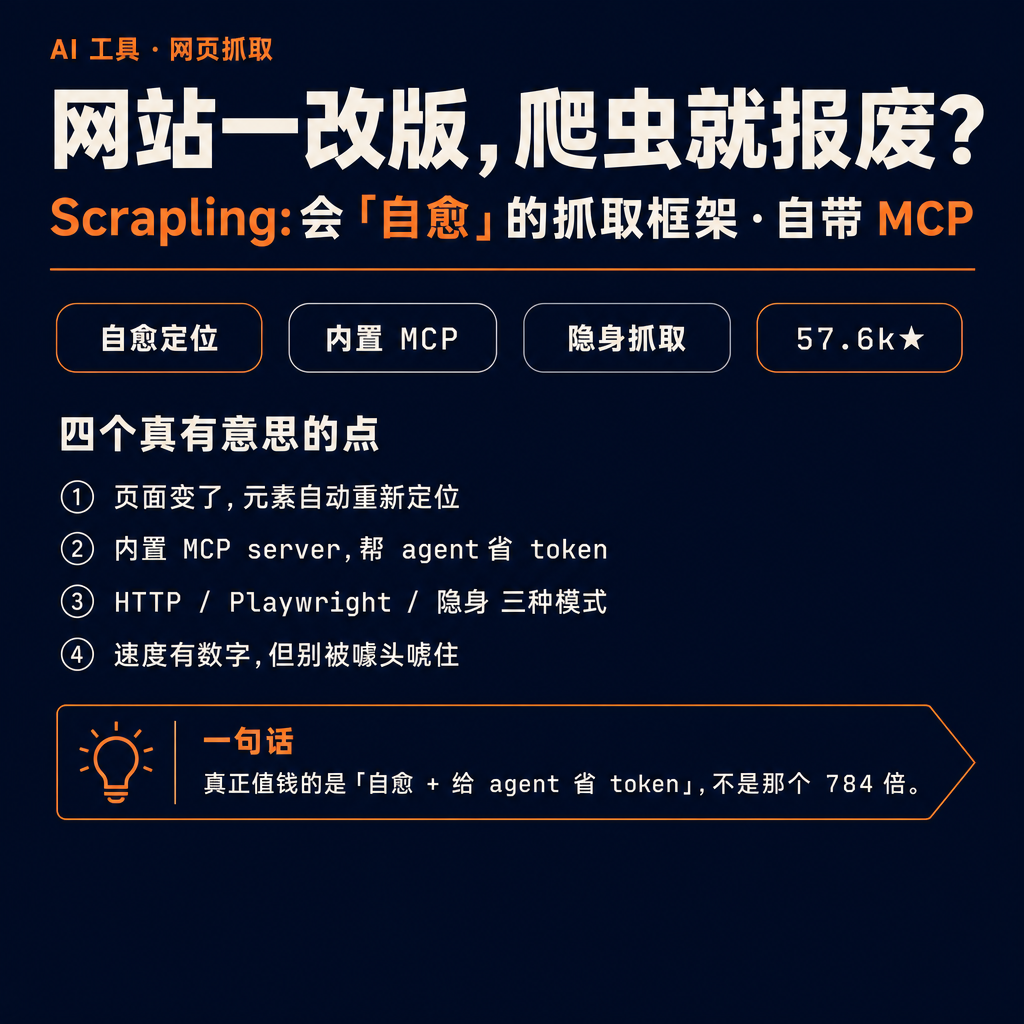
① 会「自愈」的爬虫。它最大的卖点是 adaptive:不靠写死的 CSS / XPath,而是给你要的元素存一份「特征」,等页面结构变了,再用相似度算法找回最像的那个。换个 class 名、挪个位置这种小改版,脚本不至于当场全挂,你也省了一次次回去改选择器的功夫。
② 自带一个 MCP server。这点对做 agent 的人很对味——先用 Scrapling 把页面里你真正要的内容抠出来,再喂给 Claude、Cursor 这类 agent。相当于先裁一刀,agent 不用吞一大堆没用的 HTML,token 钱也省下来了。
③ 三种抓取模式随你挑。纯 HTTP(带 TLS 指纹伪装、HTTP/3)、Playwright 浏览器自动化,还有个 stealth 模式能过 Cloudflare 的 Turnstile,配持久会话和代理轮换。⚠ 能不能用、合不合规,那是你自己得把握的事,工具只是把能力摆在这。
④ 快,但别被数字唬住。官方贴了个 784 倍:在「5000 个深层嵌套元素做文本提取」这个特定场景下,Scrapling 2.02 毫秒,BeautifulSoup 配 lxml 要 1584 毫秒。听着吓人,可这是个很窄的微基准,合成的嵌套 DOM,不代表你真实抓页面也能快这么多。
老实说,784 倍那个数我是当噱头看的。真正值钱的是前两点:改版能自愈、还自带给 agent 省 token 的 MCP。对正在搭「会自己上网找资料」那种 agent 的人,这套组合比单纯快更顶用。🧐
那什么时候值得搬过来?如果你的采集要长期跑、目标站还老改版——喂 RAG、做监控、给 agent 当眼睛这类——「自愈」这条能省下大把维护时间。要只是一次性抓一把数据就走,老办法也够,犯不上上这一套。
你写的爬虫,上次被网站改版搞挂,是什么时候?
项目地址 · 第一条评论 👇
关注 @svtransit1 · 写给真在用 AI 的人
#AI #爬虫 #AIagent #MCP #开源
原始来源:https://github.com/D4Vinci/Scrapling
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS