
你天天调 LLM 的 API,但它到底怎么从零训出来的?有人把整个过程开源了,还小到能在免费 GPU 上亲手跑一遍。🧠
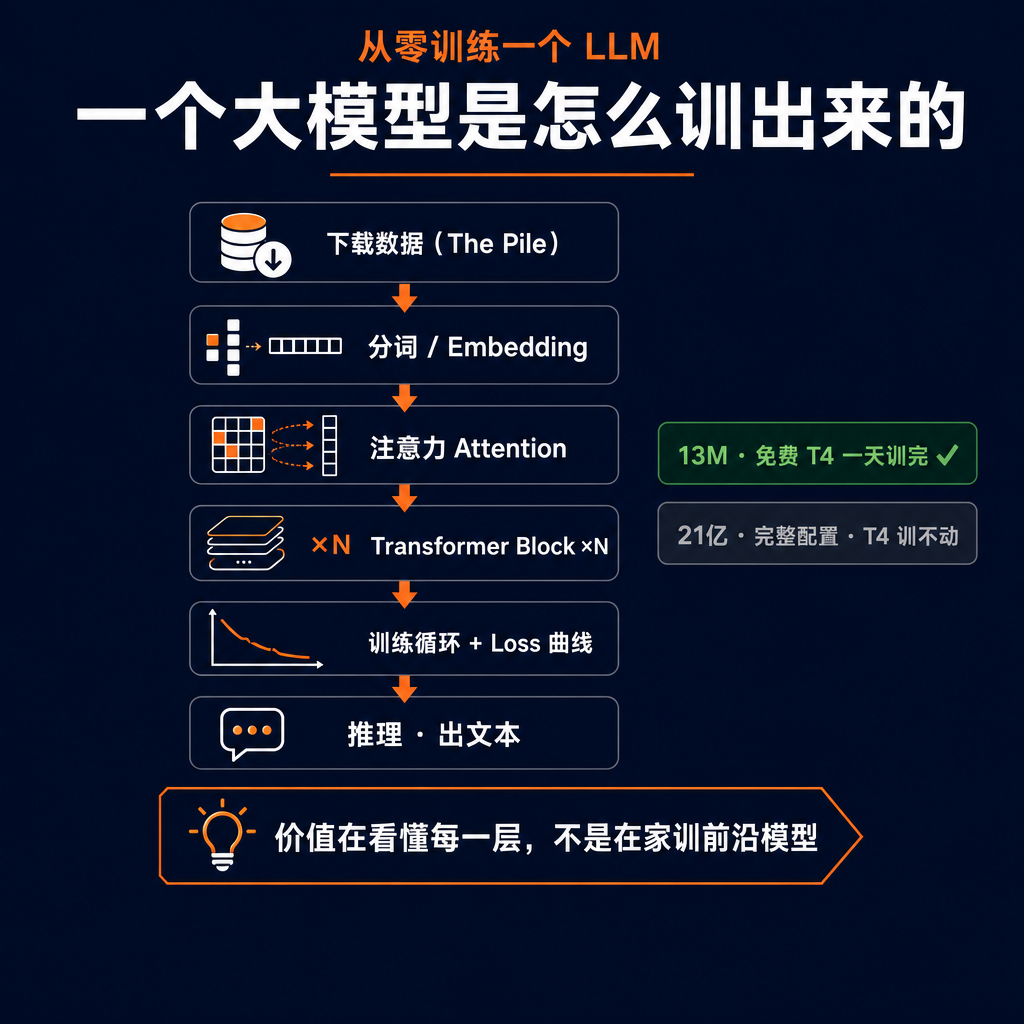
train-llm-from-scratch(GitHub 3.2k star,MIT):从下载数据,到模型吐出第一句话——MLP、注意力、transformer block、训练循环全摊开,每块配了结构图,还有训练 loss 曲线。
最实在的是那个 13M 的小模型:上下文 128、8 个注意力头、1 个 block,免费的 Colab / Kaggle T4 上,一天就能训出结果(数据用 The Pile,只取 5%~10%)。另一套 21 亿参数的完整配置(精确到 2,141,346,251),放出来是让你看清往上 scale 的样子——作者写得很白:T4 训不动,别想在家训前沿模型。
它真正值钱的地方,是把那层窗户纸捅破:亲手训过一个哪怕只有 13M 的模型,再回头看那些千亿大家伙,脑子里就有了实感,而不是一堆名词。🧐
挑个周末跑一遍,比啃十篇论文实在。
代码仓库 · 第一条评论 👇
关注 @svtransit1 · 写给真在用 AI 的人
#AI #大模型 #LLM #机器学习
原始来源:https://github.com/FareedKhan-dev/train-llm-from-scratch
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS