
同样让 AI 改一份代码,有的 agent 又慢又费 token,有的就利索很多。差别常常不在用哪个模型,在「它到底怎么改、怎么读」。拿昨天刚更到 v15.7.6 的终端编程 agent omp(oh-my-pi)来说,它跟传统 agent 的不一样,集中在三件事上。🧐
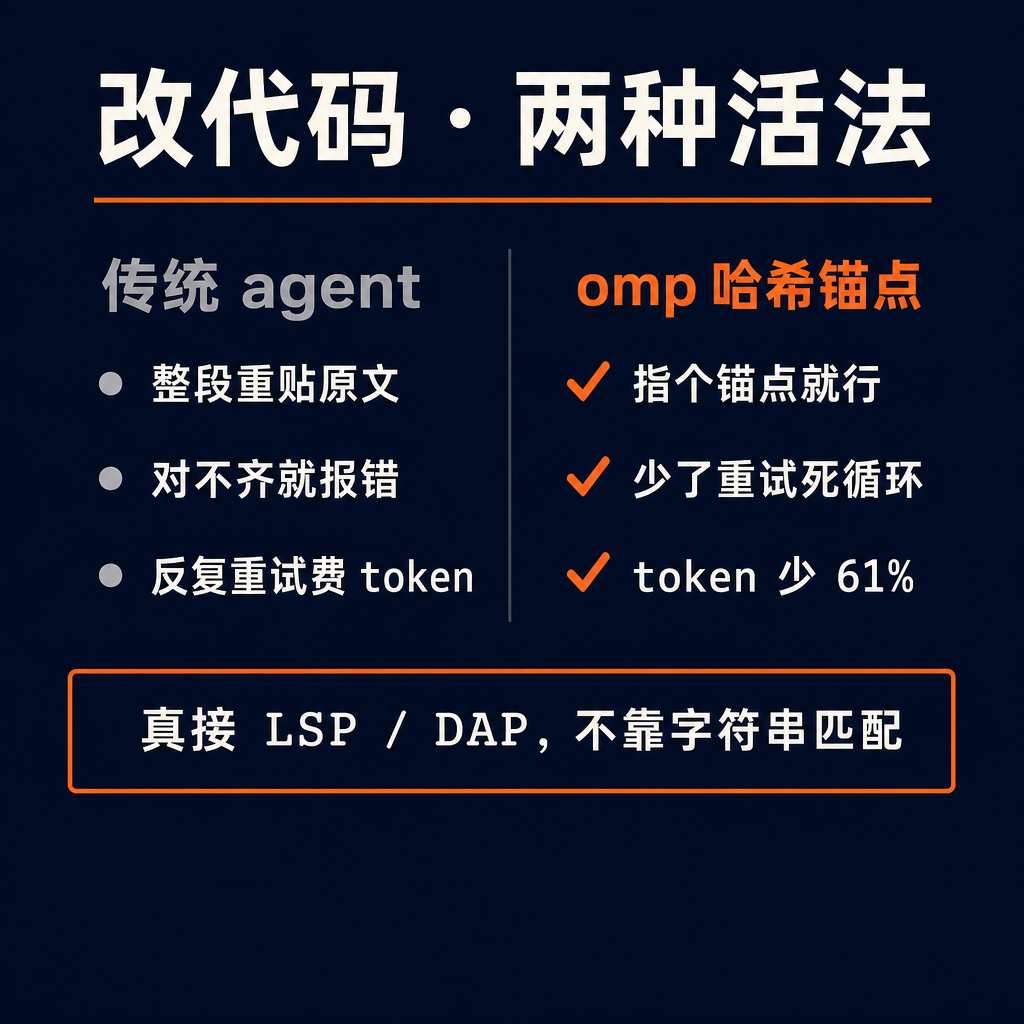
一、改代码:哈希锚点 vs 整段重贴 🔧
传统做法是 str_replace——把要改的原文整段贴出来再替换。这有两个老毛病:稍微对不齐就报「string not found」,改不进去,于是反复重试,几个回合下来又慢又贵;而且每次都把原文整段贴一遍,token 哗哗地烧。omp 换成「哈希锚点」:模型只要指认一个内容锚点,不用把整行重打,也少了那种「改不进去→重试→还是改不进去」的死循环。作者自己测,Grok 4 Fast 在同样的活儿上,输出 token 少了 61%。
二、读代码:真接 LSP / DAP vs 字符串匹配
不少 agent 是靠「字符串匹配」假装懂代码——搜到名字就当找到了,结果经常改错地方、或漏掉别处同名的引用。omp 真接了 LSP 和 DAP:重命名时能顺着 re-export、barrel 文件一起改对,不会漏;debug 能驱动 lldb / dlv / debugpy,真打断点、单步、看变量。这是 IDE 级的能力,不是靠猜。
三、上手与协作:一行装好 🛠️
| 32 个内置工具(读写、bash、跑 Python/JS、子 agent、浏览器、web 搜索……),还能 fan out 一批子 agent 并行干活,各自带类型校验、互相发消息协调。接 40 多个模型,Anthropic、OpenAI、Google、xAI 都能挂,本地 Ollama / llama.cpp 也行。想试,一行就装:curl -fsSL https://omp.sh/install | sh |
照例泼几盆冷水:⚠️ 一,「省 61% token」是作者自己测的,只看了 Grok 4 Fast 这一个模型、比的是 str_replace 那种格式,不是放之四海的「便宜六成」,换个模型不一定是这数。二,它是独立开源项目,跟 Anthropic 没关系,只是支持 Claude 当后端之一。三,9.8k star、还年轻,要不要塞进你正经的活里,自己 curl 下来跑一跑再判断,别只看宣传。
为什么这两点值得单独拎出来说?因为它们是会「滚雪球」的成本。一次失败的 str_replace,不只是这一刀白费,后面往往还要再贴一遍原文、再试一回——文件越大、改动越密,这种「重试税」越重,token 和等待时间一起涨。把改法和读法做扎实,省下的不是某一次的零头,是整条长任务累计下来的开销。
不过「少废 token + 真读得懂代码结构」这个方向,是对的。编程 agent 卷到现在,光会调模型已经不够了——谁在「怎么改、怎么读」这些工程细节上抠得细,谁用起来就更省心、更省钱。你现在那个 agent,改代码是哪种方式?
链接 · 评论区第一条 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #ClaudeCode #AI编程 #编程agent #开发者工具
原始来源:https://github.com/can1357/oh-my-pi
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS