
开源的小模型,能追上 OpenAI、Gemini 那种「会自己操作浏览器」的闭源 agent 吗?微软刚挂出来的一篇论文 OpenWebRL,给的答案有点出乎意料。🧐
问:它到底做到了什么?
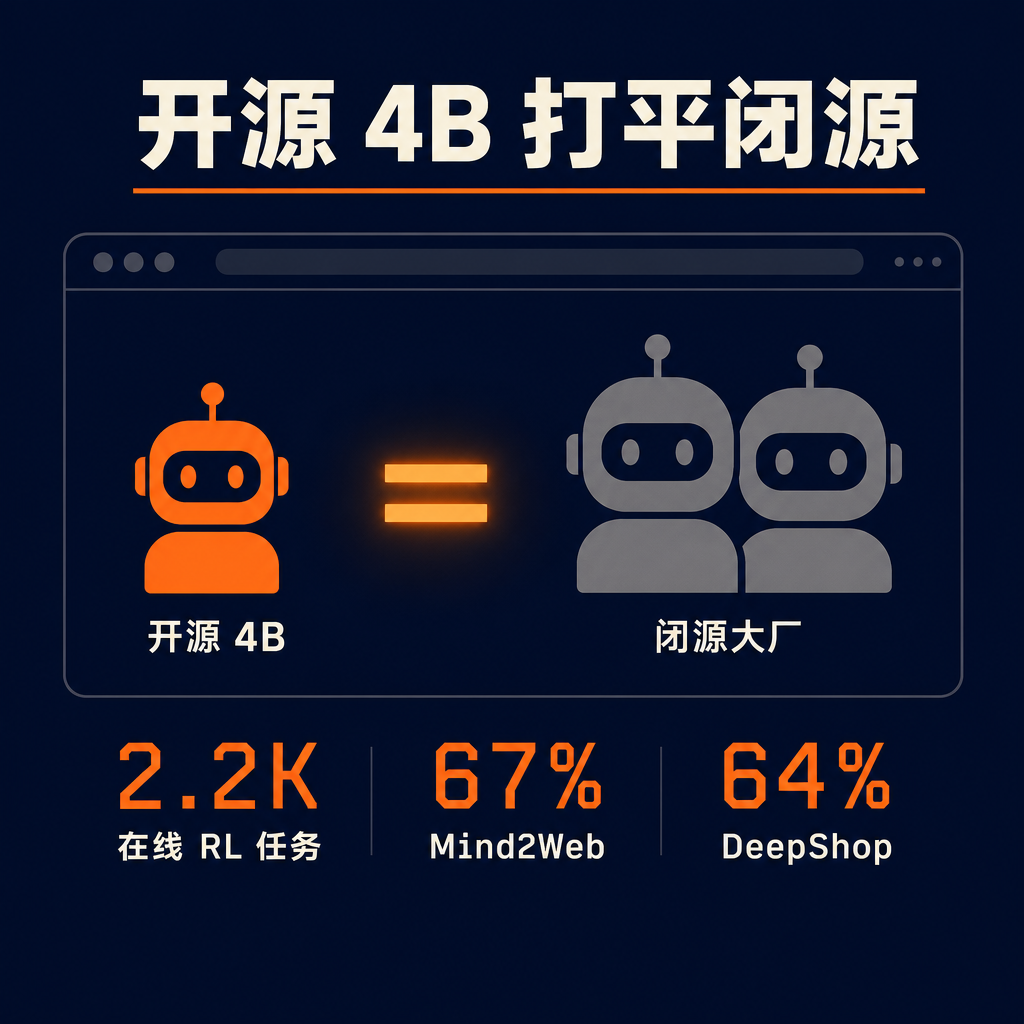
答:他们训了个 40 亿参数的开源 web agent,叫 OpenWebRL-4B,让它在真实网页上跑多轮任务——点按钮、填表单、一步步把事办完。🌐 结果在两个真实网页基准上:Online-Mind2Web 67%、DeepShop 64%,跟 OpenAI、Gemini 那种闭源的「电脑操作 agent」打成了平手。注意,是「接近、打平」,不是碾压。
问:一个小模型,凭什么追上?关键在哪?
答:在线强化学习(online RL)。以前训 web agent,主要靠喂大量人工演示——又贵又难扩。OpenWebRL 换了条路:让 agent 直接在「活的」网页上反复试错,用强化学习自己学。而且训练量小得惊人——只用了 0.4K 条初始轨迹,加 2.2K 个 RL 任务,就把一个 4B 模型拉到了这个水平。论文把整套怎么搭都讲了:基础设施、初始化、上下文怎么管、任务成没成功怎么判、策略怎么优化。
问:这对普通人意味着什么?🤖
答:web agent 就是「让 AI 替你在网页上办事」那条线——订票、比价、填一堆表。一直以来,真能打的基本都是闭源大厂。如果一个 4B 开源模型,用很省的 RL 预算就能逼近它们,说明这条能力的门槛在快速往下掉;以后那种跑在自己机器上、自己能调的 web agent,会越来越现实。
⚠️ 照例泼盆冷水:一,这是研究论文,模型和代码说「会开源」,但还没放出来,今天还下不到;二,是「打平、接近」闭源,不是超过,别夸大;三,它本质是个「看着截图操作」的视觉 web agent,真上各种网站稳不稳、扛不扛得住改版,还得等大家上手验。
开源追闭源这事,这两年一直在发生。下次再听到「这个只有大厂做得了」,可以多留个心眼。
链接 · 评论区第一条 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #AIagent #开源模型 #强化学习 #web智能体
原始来源:https://arxiv.org/abs/2606.02031
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS