
AI 看图现在到底多强?有个刚出的基准 SOCO 专门去戳它一个软肋。结果挺反直觉:你用嘴说,它找得到;你拿图比,它就含糊。🧐
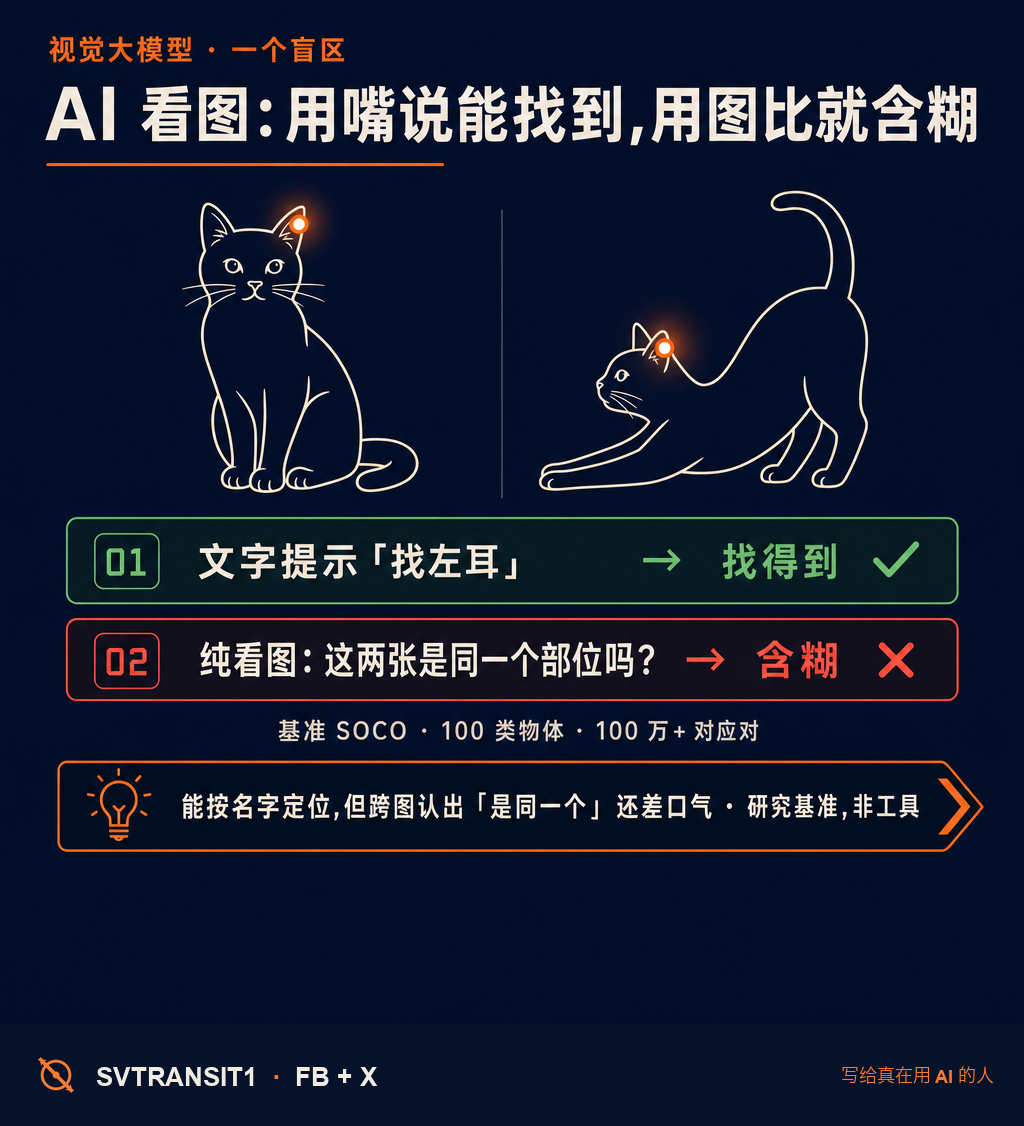
问:SOCO 测的到底是什么?
答:「语义对应」——认不认得出「这张图里的这个部位,跟那张图里的那个,是同一个东西」。比如两只不同的猫,模型知不知道这只的左耳对应那只的左耳。它收了 100 类物体、一百多万对对应关系,每个关键点还配了文字描述。
问:那大模型强在哪、弱在哪?
答:用文字下命令——「找猫的左耳」——现在的视觉大模型(LVLM)定位得挺准。可换成纯视觉:给一张图当参照,让它在另一张图里找出「同一个部位」、不靠任何文字,它就明显吃力。论文的说法是,靠语言搭桥的定位,跟细粒度的「跨图视觉对应」,中间还差一截。
问:为什么文字能找到、纯看图反而不行?
答:文字相当于给了个「语义锚点」——模型把「左耳」对到它学过的概念上,顺着概念去定位,这种它训练时见得最多。可纯视觉匹配要的是细粒度的几何、部件级对应,得真「看出」两块像素区域指的是同一个结构,这恰恰是短板。SOCO 还专门给对应关系分了类型(做了套 taxonomy),就是想把这种细分能力测清楚,而不是笼统打个分。
问:这盲区要紧吗?
答:挺要紧。「跨图认出是同一个东西」是一堆下游任务的地基——目标跟踪、3D 重建、机器人抓取都靠它。而且现在不少评测,允许模型借文字标签把答案套出来,等于顺手把这块短板也遮上了,纸面分数会偏乐观。能力是真长了,但别被「全能」的说法带跑。
⚠ 说清楚:这是个研究基准,不是能直接上手的工具;项目页挂出来了,数据和代码能不能下还得等确认。也别上纲上线成「AI 视觉不行」,它只是点出了一个挺具体的盲区。
下次再看到「多模态大模型视觉理解封神」的说法,可以多问一句:是它真在「看」,还是你用文字替它把答案说出来了?
来源 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #多模态 #视觉模型 #LVLM #AI能力边界
原始来源:https://arxiv.org/abs/2605.31597
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS