
训练 AI「听懂人话」一直有个老大难:缺数据。尤其是小语种、专业领域,根本凑不齐足够多的、多说话人的真实对话录音。有篇刚出的论文干脆反着来——既然真的不够,那就造一批「从没发生过的对话」。🧐
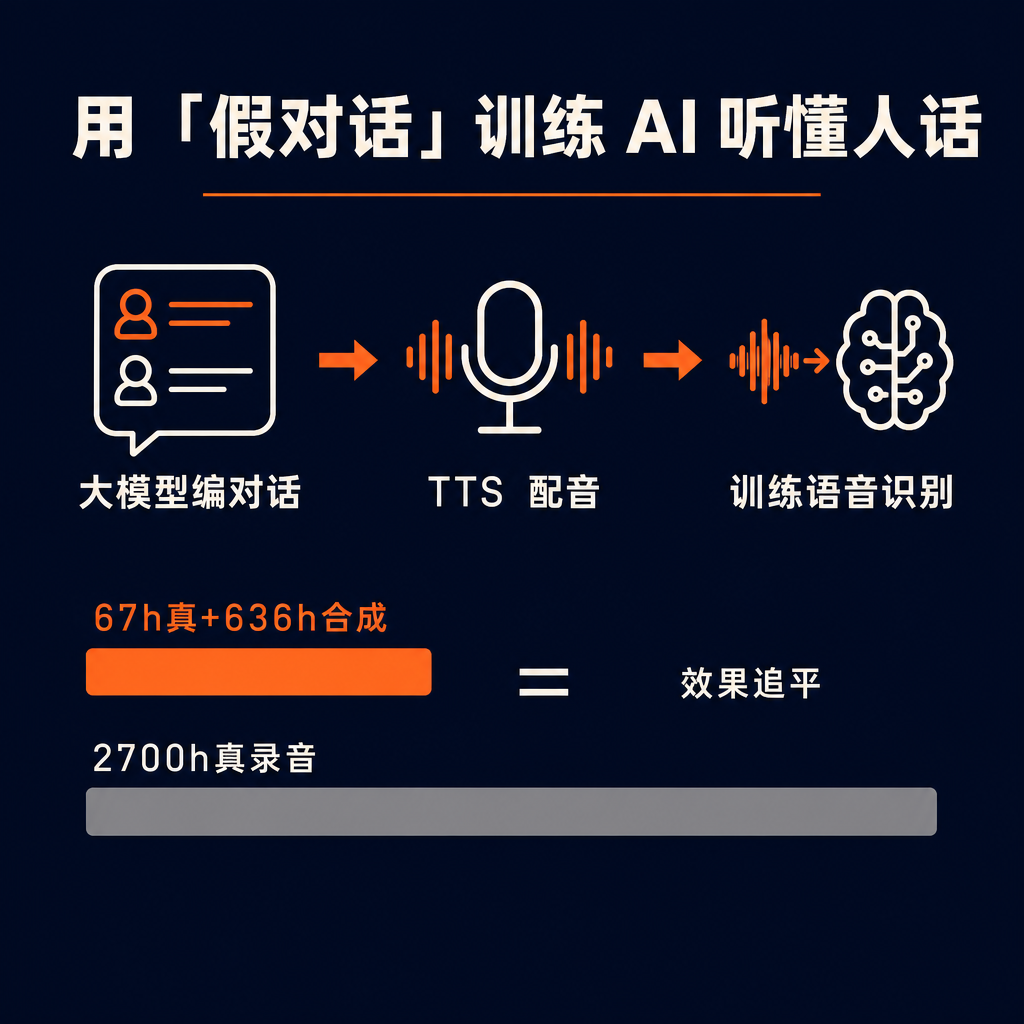
做法挺巧:先让大模型按场景编出一段段对话,连「谁是谁、什么角色、什么口音」这些参与者信息都给你安排上;再把每个人对应到一个 TTS 音色合成出语音;最后拼成一段段有模有样的多说话人对话。说白了,就是 AI 编剧 + AI 配音,凭空造出训练语料。🎙️
效果有点唬人:在匈牙利语的一个对话基准上,只用 67 小时真实录音 + 636 小时合成数据,就追平了一个拿 2700 小时真实语音训出来的模型。约等于用四分之一的数据量、而且大部分还是假的,做到了差不多的水平。
照例泼盆冷水:⚠️ 一,这是在一个小语种、一个基准上测的,换语言、换领域还成不成,得另说;二,它追平的是个 zero-shot 基线,不是「吊打所有语音识别」;三,合成数据有它的坑——TTS 的腔调、分布的偏差都会影响,论文自己也强调,造数据时「怎么配比、用哪个生成器」关系很大。
不过这个思路是真有意思:当真实数据成了瓶颈,「造数据」正从一种作弊感很强的捷径,慢慢变成一门正经手艺。下次再听到「这个领域没数据,AI 做不了」,可以多想一层——也许缺的不是数据,是造数据的方法。
你觉得「用 AI 造的数据训练 AI」,这条路能走多远?
链接 · 第一条评论 👇
关注 @svtransit1 · 写给真在用 AI 的人
#AI #语音识别 #合成数据 #大模型 #AI测评
原始来源:https://arxiv.org/abs/2606.03957
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS