
做 IntelliJ、PyCharm 那家 JetBrains,悄悄开源了一个会「把思路写出来」的推理模型——Mellum2。这事比它的跑分更值得说一句:一家做 IDE 的公司,正经下场做模型了。🧐
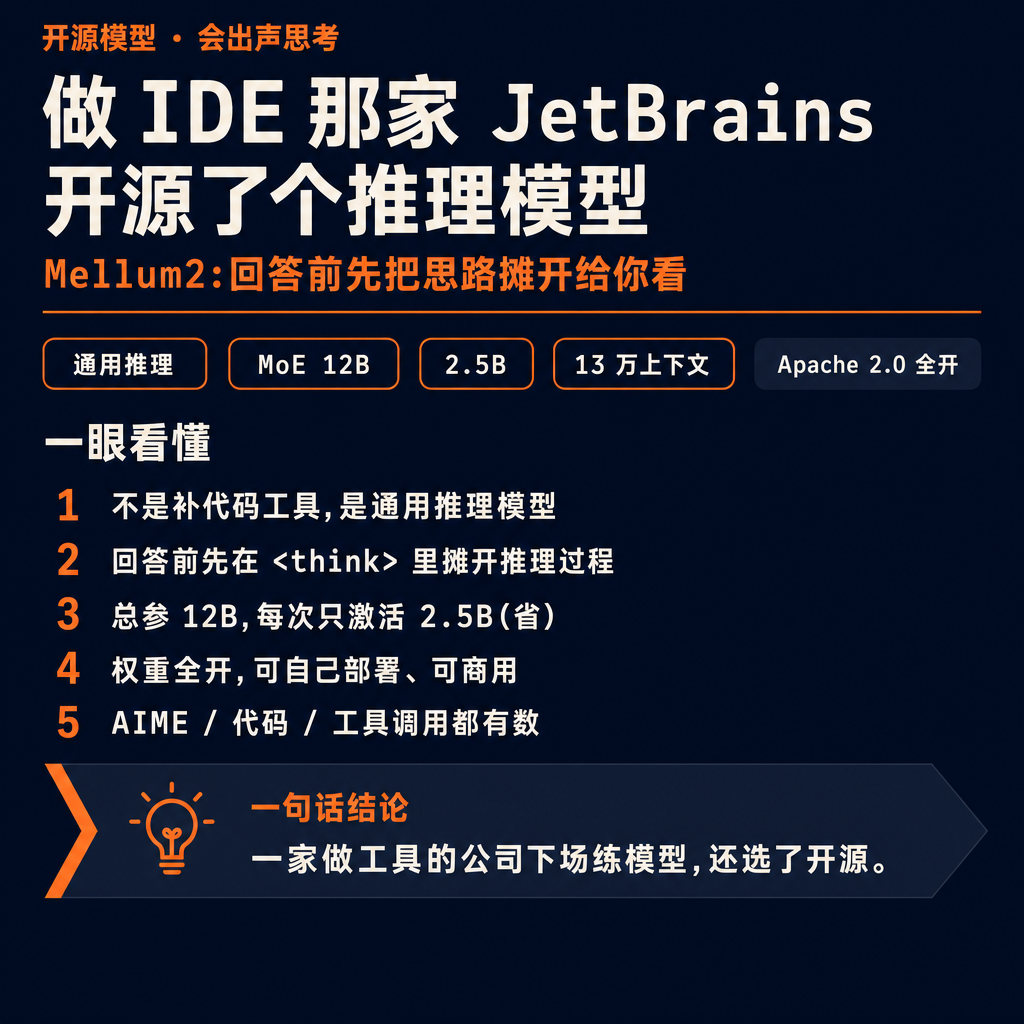
先说它是什么。Mellum2 不是只会补代码的那种工具模型,而是一个通用的推理模型——官方自己的说法是,适合「复杂调试、多步规划、agent 流程、还有数学和推理重的活」。回答之前,它会先在 ⟨think⟩ 标签里把推理过程摊开,你能看见它是怎么一步步想到答案的,而不是直接甩你一个结论。
再看它的「身材」。它用的是 MoE(混合专家)架构:总共 12B 参数,但每次只激活其中 2.5B——64 个专家里挑 8 个干活。说白了,模型不小,但实际跑起来的开销,接近一个 2.5B 的小模型。这意味着两件事:推理更便宜、对显存更友好,普通点的机器也更容易喂得动;🔓 再配上 Apache 2.0 的完全开放权重,你可以直接拉下来自己部署,不用每次调用都给某个闭源 API 交「过路费」。上下文还给到 13 万 token,长文档、长 agent 流程都够用。
对谁有用?最直接的是两类人:做 agent 的,能拿它当一个「会出声思考」、还便宜的推理核心;以及天天 debug、希望它一步步讲清楚「为什么这么改」的人——过程看得见,排错和信任都更容易。
它怎么练出「会想」这件事?🧠两步:先用监督微调(SFT)喂它一堆带推理过程的题;再上 RLVR——「带可验证奖励的强化学习」,拿那些答案能被自动判对错的难题(比如长链数学)去磨它。简单说,就是让它在「能判分」的题上反复练,把推理练扎实。
跑分也摆出来了(都是 JetBrains 自己测的):AIME 数学 58.4%,GSM-Plus 87%,MMLU-Redux 86.2%,代码的 LiveCodeBench 69.9%,工具调用 BFCL 45.6%。这几项里,数学和通识本就是 thinking 模型容易吃分的地方,代码和工具调用则刚好戳中开发者最常用的场景。📊 对一个「激活才 2.5B」的开源模型来说,这组数挺能打——尤其考虑到你能免费把它整个搬回家。
照例泼盆冷水:⚠️ 一,这些分都是官方自己报的,等第三方复现了再下结论;二,「能打」是指对它这个体量、还开源,别理解成吊打 Opus、GPT 那一档闭源大模型,人家分更高;三,它毕竟出自一家 IDE 公司,通用是通用,但骨子里对编程、调试这类活,大概率比别的方向更上心——当个通用备选可以,别指望它每个方向都一样均衡。
不过我觉得这事的信号挺清楚,有三层:
一是「小激活、大容量」的 MoE,正在成为开源模型的默认形态——既要把能力堆上去,又要把每次推理的成本压下来,12B 装着、2.5B 跑着,就是这个意思。
二是「把思路写出来」的 thinking 模型在快速变多。对做 agent、要 debug 的人,能看见模型一步步怎么想,比只丢给你一个答案有用太多了:错在哪一步、为什么这么判,一目了然,也更敢把它放进正经流程里。
三是连一家做 IDE 的工具公司,都开始自己练模型、还选择开源。模型这一层,正从「少数几家大厂的专利」,慢慢变成「有数据、有想法的人都能下场」的东西。开源每往前拱一步,闭源 API 的「非用不可」就少一分。
你会愿意用一个「能看见它怎么想」的开源模型,来替掉手里某个闭源 API 吗?还是说,自己部署那点麻烦,你宁可继续付 API 的钱?
模型链接 · 第一条评论 👇
关注 @svtransit1 · 写给真在用 AI 的人
#AI #开源模型 #推理模型 #大模型 #AIagent
原始来源:https://huggingface.co/JetBrains/Mellum2-12B-A2.5B-Thinking
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS