
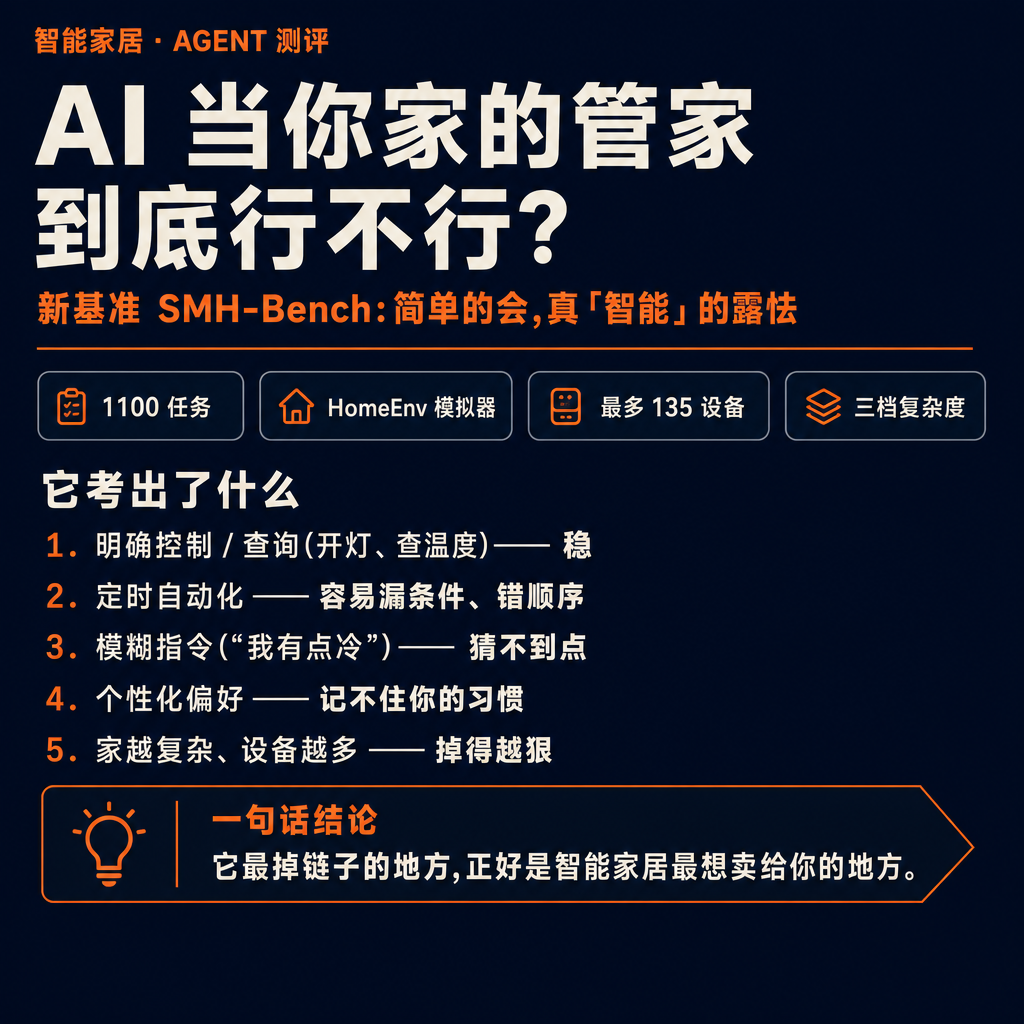
让大模型当你家的「智能管家」,它到底能不能管明白?有个刚出的基准 SMH-Bench,搭了个真能跑的智能家居模拟器 HomeEnv,把任务分成 7 大类、22 个小类、三档复杂度,拿 1100 个任务把前沿大模型挨个考了一遍。结论有点微妙:简单的它都会,真正「智能」的地方反而露怯。挑三个发现说说。🧐
1️⃣ 开灯、查温度这种,没问题。
你直接下命令——「把客厅灯打开」「卧室现在几度」——这类明确的控制和查询,前沿大模型答得挺稳。日常的「听话办事」,基本不用担心。
2️⃣ 一到「定时自动化」,就开始飘。
让它安排「每天日落后拉上窗帘、空调调到 26 度、顺手把门锁上」这种带条件、带时序、还得多设备配合的自动化,它就容易漏掉某个条件、搞错先后顺序。而且家越复杂、设备越多(基准里最多堆到 135 个设备),它掉得越狠——可这恰恰是大房子里最需要它的场景。🏠
3️⃣ 模糊指令和个性化,是重灾区。
你随口一句「我有点冷」,它得自己推断:是开暖气、还是关窗?调到几度——最好还是你平时偏好的那个温度。这种要结合当下意图加个人习惯的活,它经常猜不到点上。一个连你「冷了想要什么」都摸不准的管家,谈不上贴心。
4️⃣ 复杂度一上来,差距就拉大。
基准特意把家分了三档,从小公寓到堆满设备的大房子。模型在简单环境里还能撑撑场面,可一旦设备一多、各种状态互相牵连,该协调的协调不好、该记的状态记不住——越接近真实的大户型,越露馅。换句话说,它最掉链子的地方,正好是「智能家居」最想卖给你的地方。
SMH-Bench 测的不是「会不会说话」,而是「能不能在一个真实环境里,既看懂状态、又把事真办成」——也就是所谓「环境感知的推理与执行」。这正是 agent 从聊天框走进物理世界要过的那道坎。
为什么值得记一笔?因为「智能家居」喊了这么多年,真正卡住的从来不是「开关灯」,而是这些需要推理、记住偏好、按情境做决定的部分。这些短板平时被一句句宣传话术盖着,你不专门测,根本看不见;SMH-Bench 的价值,就是把它量化出来、摆到台面上——毕竟测不出来的毛病,也没人会去修。
照例泼盆冷水:⚠️ 一,这是个研究基准,不是能直接装进你家的产品;二,配套的 HomeEnv 模拟器是整套测试的地基,但数据和代码能不能下、好不好复现,还得等确认;三,这些结论是这一个基准测出来的,别当成盖棺定论。
下次再看到「AI 全屋智能管家」的宣传,可以多问一句:它是真懂你这个家,还是只会听话开关灯?
论文链接 · 第一条评论 👇
关注 @svtransit1 · 写给真在用 AI 的人
#AI #智能家居 #AIagent #大模型 #AI测评
原始来源:https://arxiv.org/abs/2606.01912
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS