
你天天用的大模型,到底是被哪些数据「喂」大的?这个问题以前几乎没法查——有篇新论文把它快了 13 倍,顺带能干一件更戳人的事:查模型有没有「偷看过考卷」。🧐
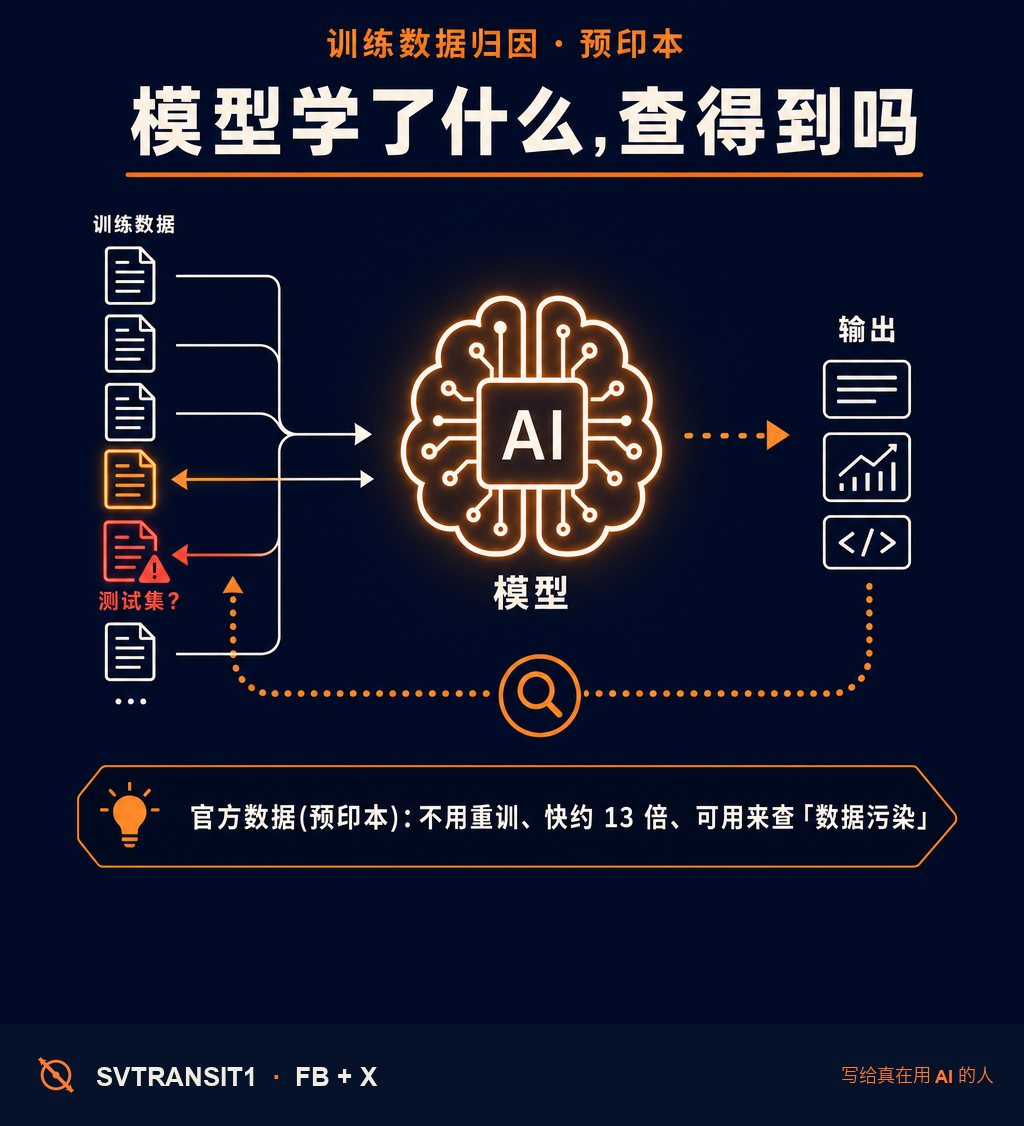
先说为什么难查。「训练数据归因」想搞清楚:模型的某个回答,到底是被训练集里哪些例子影响出来的。最朴素的办法是「抽掉一批数据、重训一遍、看变化」——可 LLM 动辄几千亿参数,重训一次的成本够烧一阵,根本没法反复来。所以这事一直卡在「理论上能做、实际做不起」。
STRIDE 怎么绕开?它不碰参数、也不重训,而是在「激活空间」里做文章:学一批轻量的「操控算子」,去模拟「假如在某批数据上训过,模型行为会怎么变」,再用稀疏分解把影响倒推出来。官方说,比之前最强的方法快了 13 倍,在 LLM 预训练归因上做到了 SOTA。⚡
这能拿来干嘛?三件实在事:挑数据(知道哪批数据真有用)、做定性分析(理解模型为啥这么答),还有最戳人的一个——查「数据污染」。说白了,就是看模型训练时有没有偷看过测试集。要是跑分高只是因为「考前背了答案」,那分数就得打个折——这恰恰是大家天天吵的「benchmark 到底实不实」的核心。而且污染往往不是故意的:网上的题库、评测集被人转来转去,很容易就混进了几十 TB 的训练语料里,事后根本说不清。能便宜地反查「这道题模型是不是见过」,价值就在这。
照例把话说清楚:这是预印本、作者自己测的;摘要里除了「快 13 倍」,没给别的硬指标(比如归因准确率),SOTA 是它自己的说法,暂时没第三方复现。而且「归因」这事本身就是近似——它给的是「最可能的影响来源」,不是铁证。
但方向挺重要:模型越来越大、越来越黑箱,「它到底学了什么、有没有作弊」要是能便宜地查清楚,对「我们能不能信它」这件事,是实打实的帮助。下次再看到「又刷新了 SOTA」,你会先想想它是真强,还是见过卷子吗?
来源 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #大模型 #训练数据 #AI可解释性 #AI论文
原始来源:https://arxiv.org/abs/2606.05165
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS