
Transformer 注意力里那套 Q、K、V「三件套」,真有必要都分开、各算一套吗?有篇 ICML 2026 的论文较了个真——发现至少 K 和 V,是可以合着用的。🧐
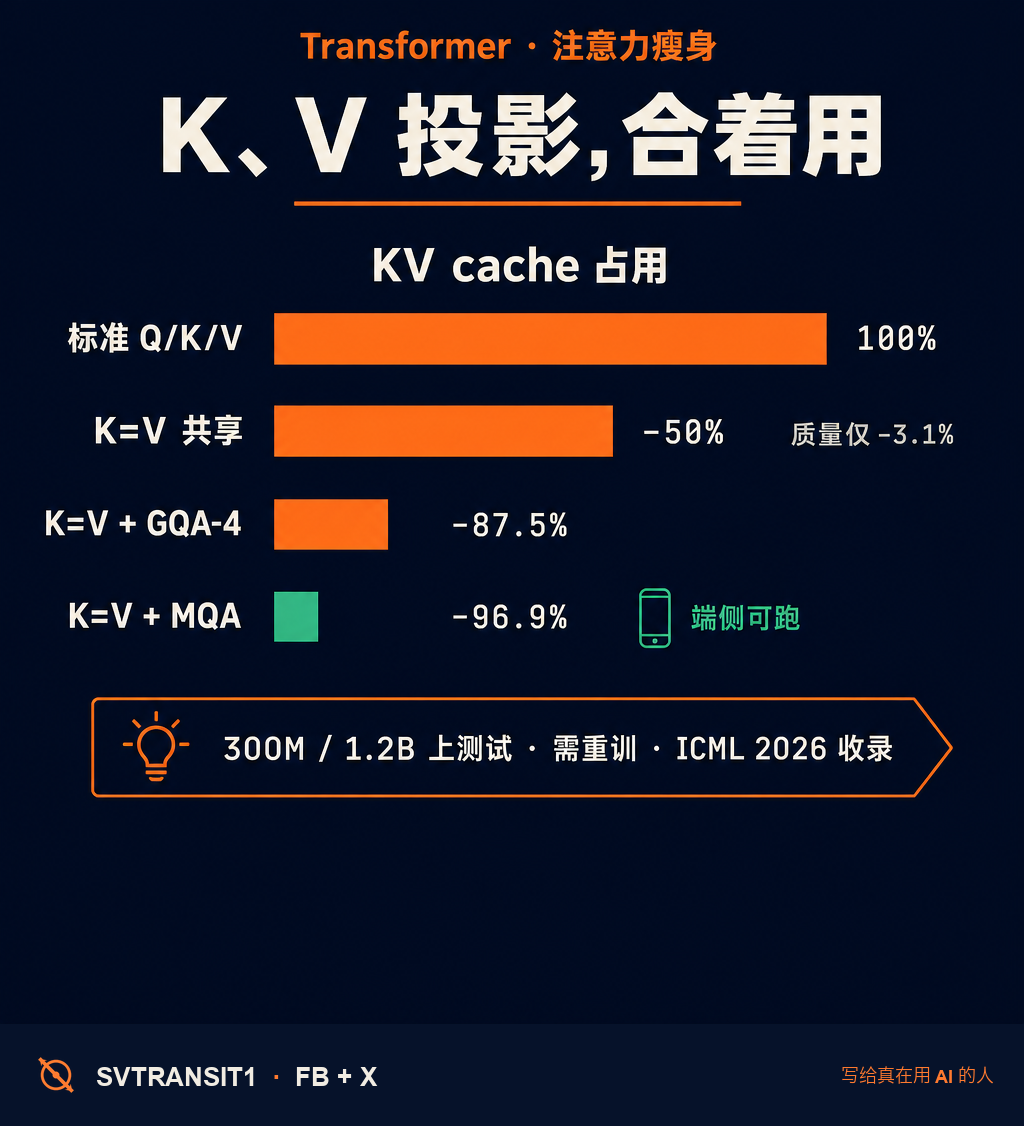
先说为什么有人盯上这里。简单讲,模型每读一段上下文,都会把算过的 K、V 存进一个叫 KV cache 的地方,好让后面不用重算——上下文越长、并发越高,这块显存就涨得越凶,经常是「长上下文为什么这么贵、这么吃内存」的元凶。想省显存、想把长上下文塞进小一点的机器,KV cache 几乎是第一个要开刀的地方。
论文把几种做法摆在一起比:
· 标准款:Q、K、V 各用一套投影,教科书写法,也最占地方。
· K=V 共享(它主推的):让 K 和 V 共用同一套投影。结果是——KV cache 直接砍一半(−50%),质量只掉了 3.1%(困惑度)。
· 再叠加现有技巧:GQA 和 MQA 是现在很多模型早就在用的「多头共享」省法,而这套 K=V 共享能跟它们叠加——K=V + GQA-4,cache 砍 87.5%;K=V + MQA,砍到 96.9%,小到能在端侧设备上跑。也就是说,它不是要取代现有方案,而是在上面再省一刀。
那为什么 K 和 V 能合、Q 却不能?作者的解释挺直觉:K 和 V 表示的空间本来就靠得很近,而注意力本身又是「低秩」的(信息没塞那么满),所以合并损失很小;但你要是去共享 Q 和 K,就会把注意力的「方向性」搞坏,那条路走不通。
对普通用户意味着什么?短期你啥也不用做——这是模型「怎么造」的事,不是你能改的设置。但往前看,如果下一代模型把这种省法吃进去,同样的硬件也许能跑更长的上下文、扛更高的并发,长文档、长对话的成本和延迟都可能往下走。顺带一提,作者不只在语言模型上测,连 MNIST、CIFAR 这些视觉任务也试了,说明这套「投影其实可以共享」的观察,不太挑场景。
照例把话说清楚:这是在 300M 和 1.2B 两个不算大的模型上测的,能不能稳稳搬到几百亿、上千亿的大模型,论文没给答案;3.1% 的质量损失也不是零成本;部分变体还得换一种特殊的位置编码,不是给现有模型「一键瘦身」。好的一面是——它是 ICML 2026 收录的(过了同行评审),代码也开源了,比一般预印本扎实不少。
但这个问题本身就挺提神:我们习以为常的模型结构里,可能还藏着不少「并不必要」的开销。下一代模型,说不定就更省了。
转给那个天天在本地跑模型、和显存死磕的朋友。
原文链接放在第一条评论 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #Transformer #大模型 #推理优化 #AI论文
原始来源:https://arxiv.org/abs/2606.04032
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS