
你有没有发现,现在的「推理模型」特别爱想太多?明明一步能到的题,它非要绕一大圈、反复试错,token 哗哗地烧。有篇刚出的论文 ThoughtFold,专门治这个毛病。🧐
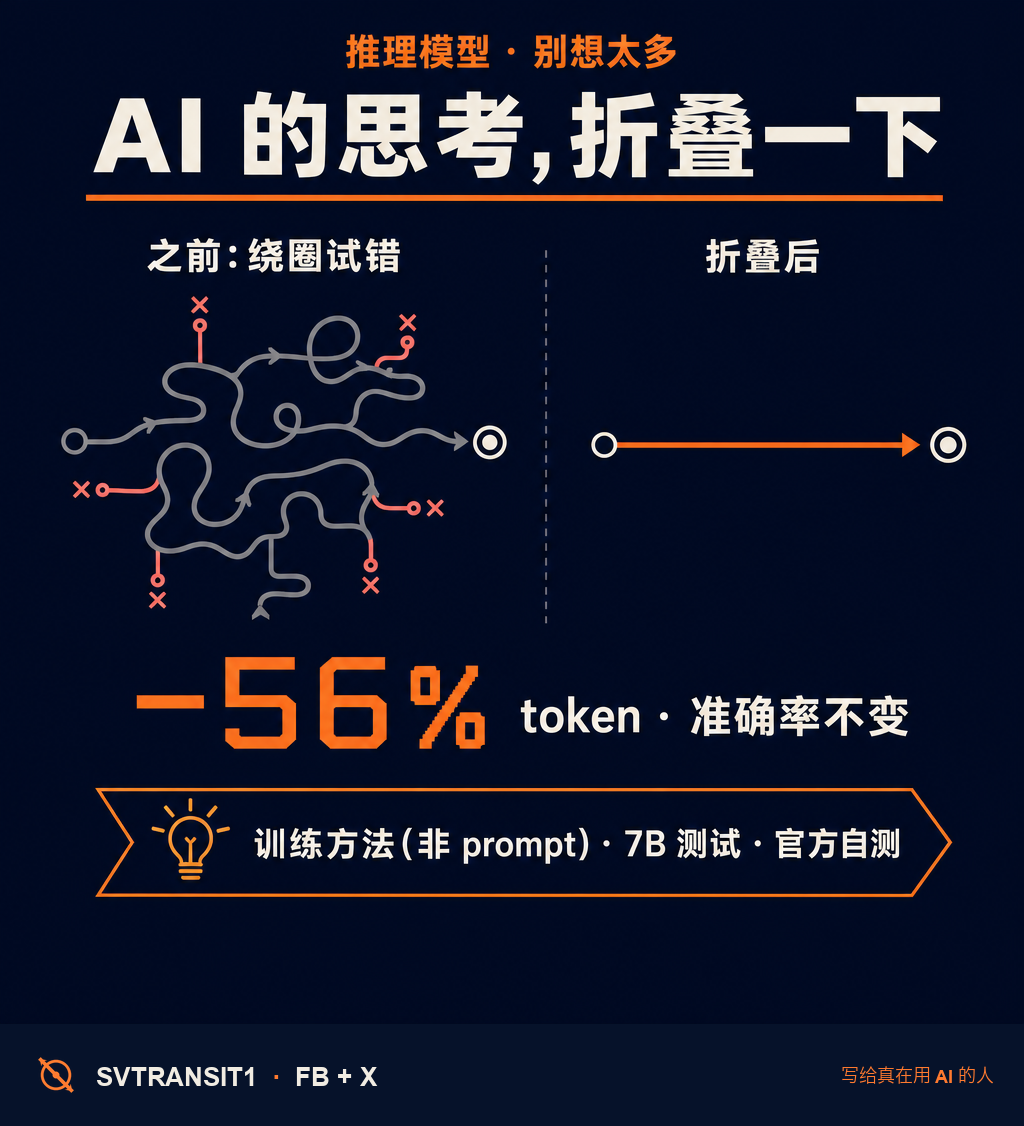
它的观察挺实在:这些模型的「思考链」里,塞了一堆「试了又退回去」的冗余探索。而现在主流的强化学习训练,反而会把这些绕路也一并「奖励」进去——于是越练越啰嗦。
ThoughtFold 的做法分两步:先用一个「自省」环节,在每条最终答对了的推理里,挑出哪些步骤其实是多余的;再用一种带掩码的偏好优化,专门惩罚这些冗余探索,把推理链「折叠」紧。
效果:在 DeepSeek-R1-Distill-Qwen-7B 上,token 用量砍了大约 56%,准确率还保持住了。说白了,就是让模型「想得更短,但一样对」。⚡
照例把话说清楚:这是个「训练方法」,不是能直接粘贴的 prompt——得在自己的推理模型上做微调才用得上;56% 是在一个 7B 模型上测、作者自己报的数,换更大的模型还成不成,论文没说,也没有第三方复现。
但这个方向挺对症:推理模型最招人烦的,就是「废话连篇还慢」。要是「想得短」能慢慢变成标配,体验和成本都能松一口气。
转给那个也受够了 AI「啰嗦半天才给答案」的朋友。
链接 · 👇 第一条评论
关注 @svtransit1 · 写给真在用 AI 的人
#AI #推理模型 #大模型 #微调 #AI论文
原始来源:https://arxiv.org/abs/2606.03503
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS