
能在手机上本地跑、还压到 1GB 以内的大模型——Google 这次没在「模型」上做文章,在「训练」上动了刀。📱
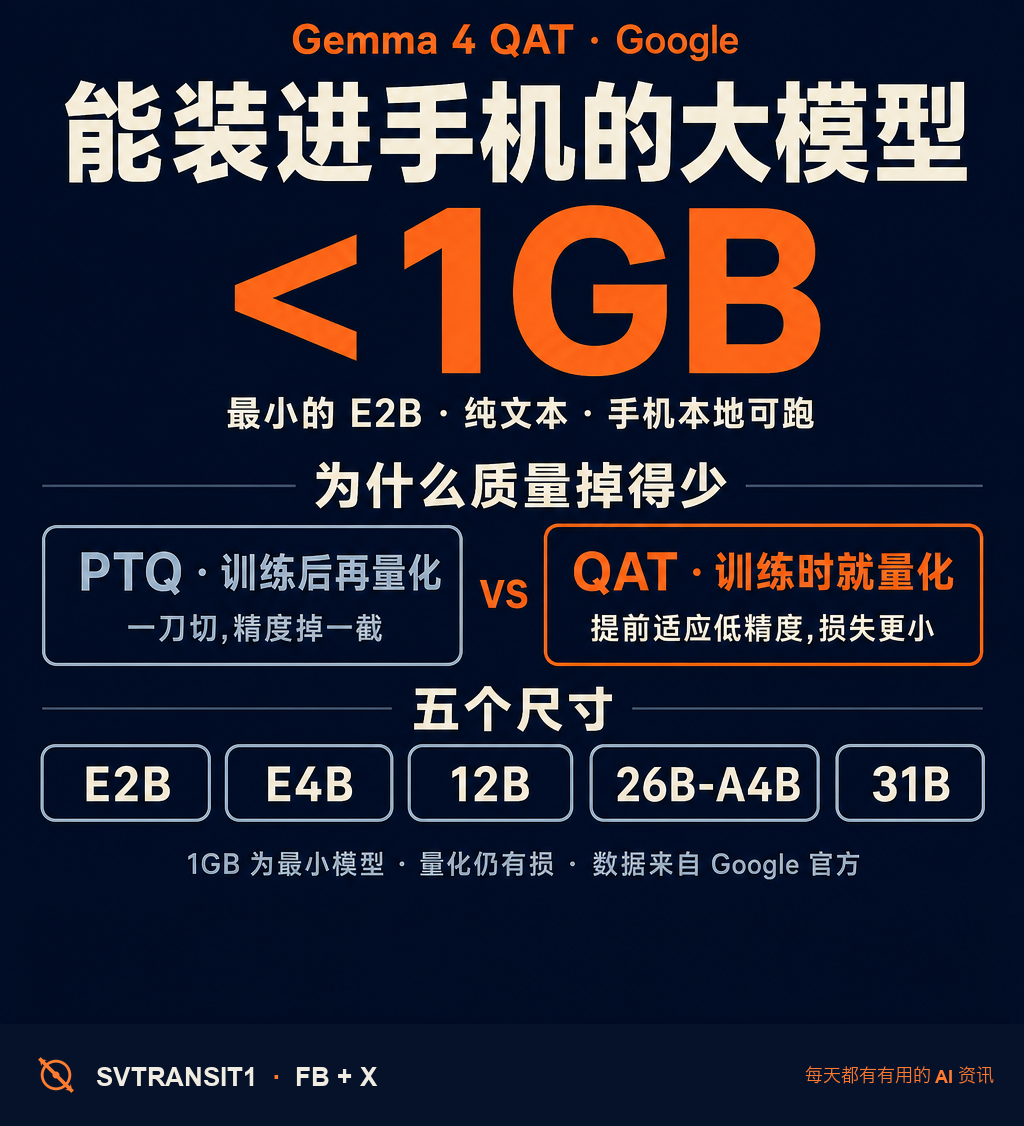
把能打的模型塞进手机,最大的拦路虎一直是内存。Gemma 4 QAT 把最小的那档 E2B 压到了 1GB 以内,手机、笔记本本地就能跑。
它真正的巧处是「怎么压」。常见做法是训练完再量化(PTQ),一刀切下去精度要掉一截;QAT 换了个思路,训练时就把「将来要被压缩」模拟进去,让模型提前适应低精度,真压下去质量损失小得多。
这次一口气放了五个尺寸(E2B 到 31B),两种量化格式——熟悉的 Q4_0,和一个专为手机做的新格式;权重挂在 Hugging Face,llama.cpp、Ollama、LM Studio、MLX 全接得上,下载即用。
为什么这么多人盯着端侧?理由很实在:数据不出本地,隐私和合规都省心;没网也能用,地铁、飞机、信号差的地方照样跑;还省掉了 API 的钱,跑多少都不按 token 计费。手机里装个离线助手,这两年正从「能不能跑」慢慢变成「够不够好用」。
⚠ 说清楚:那个「不到 1GB」是最小的 E2B、纯文本模式,不是 12B、31B 那几个大的,别指望 1GB 里塞下 GPT 级能力;QAT 只是把损失压小、不是压没,仍然有损;这些数据也来自 Google 官方,第三方还没大规模复测。
模型变强是一条线,模型变小、能装进你口袋,是另一条同样重要的线。
完整链接 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #Gemma #本地LLM #端侧AI #AI日报
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS