
你让 AI agent 帮你写代码,钱到底花在哪了?多数人脱口而出:当然是写代码。一篇今年一月的论文把 token 一笔笔数了出来,答案有点反直觉。四个值得记下来的结论 👇
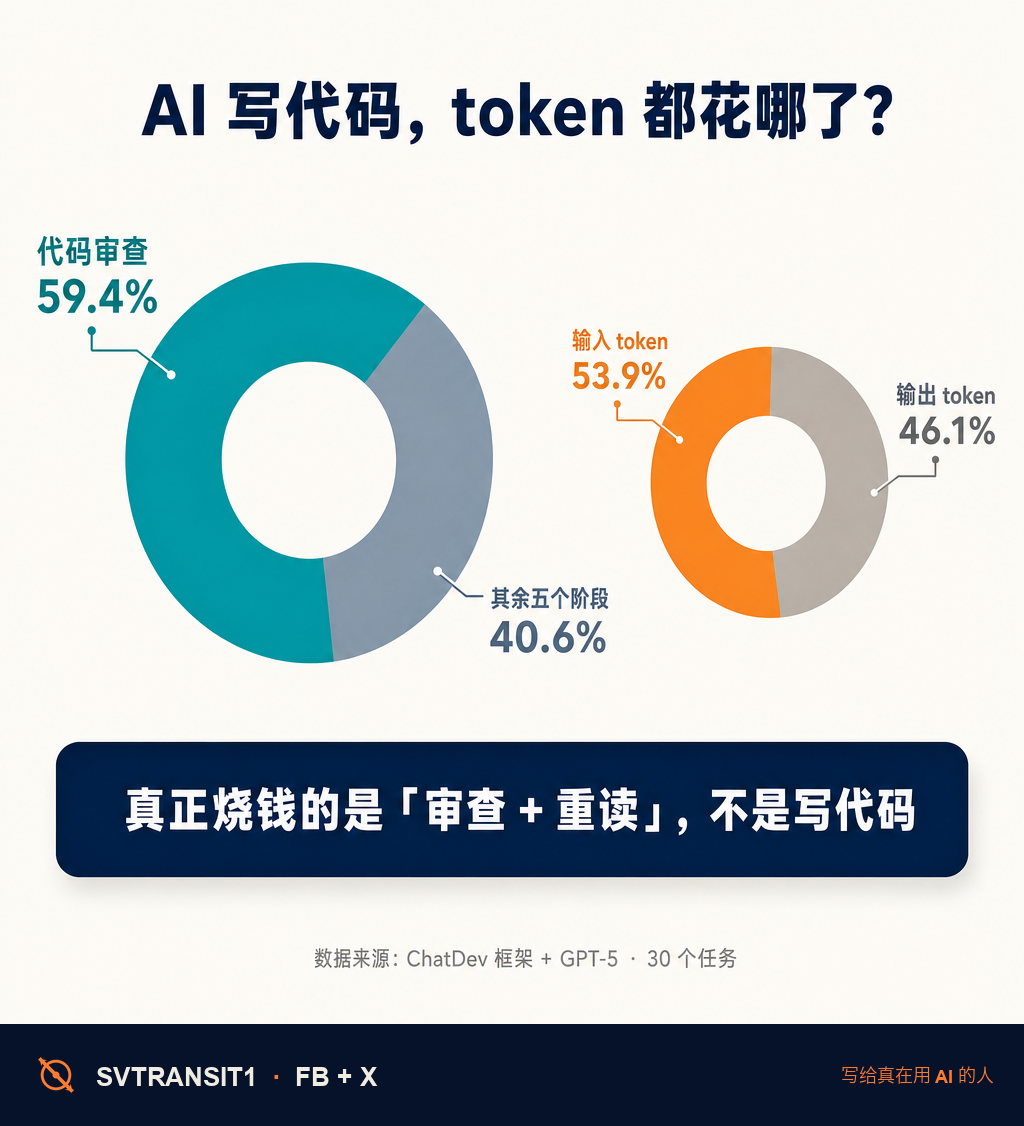
研究来自 Concordia 大学 Emad Shihab 团队,标题就叫《Tokenomics》。他们拿 ChatDev——一个让好几个 AI agent 分工协作、自动写软件的框架——去跑 GPT-5,做了 30 个开发任务,再把整条流水线拆成六段:设计、编码、补全、代码审查、测试、写文档,逐段数 token。
1️⃣ 最贵的不是写代码,是审查。代码审查(code review)这一个环节,自己就吞掉了 59.4% 的 token——将近六成。真正「写出代码」反而只是一小块。
2️⃣ 一半以上的钱,花在「读」不在「写」。输入 token 占了 53.9% ⚡ 每跑一轮审查,agent 都得把相关代码、这次改动、之前的对话重新整段喂进去。输出几行评语很便宜,可为了那几行,你先付了一大笔「重新读一遍」的钱。
3️⃣ 真正的成本,藏在验证循环里。论文说得很干脆:agentic 软件开发的钱,大头都烧在后面那一轮轮的打磨和确认上;最初写代码那下子,反而是小头。
4️⃣ 所以优化的方向得调个头 🔄 如果你一直盯着「让模型写得更快更好」,可能找错了地方。该省的其实是:每次审查别一股脑喂全部上下文、用便宜的小模型干审查这种重复活、别让 agent 无意义地多审几轮、把喂进去的 diff 整理干净点——这也是「实体级 diff」那类工具有意义的原因,干净的输入直接砍掉重读成本。
最后泼盆冷水 🧊 这是一个框架(ChatDev)、一个模型(GPT-5)、30 个任务跑出来的数。ChatDev 是 agent 全自动分工的重型流水线,审查天然就重;你自己开着 Claude Code 一句句交互,分布跟它并不一样。所以 59.4% 是个信号——审查和重读可能比你想的贵得多——而不是放之四海的定律。
下次 AI 编程的账单又莫名超了,先别急着怪它写得啰嗦 😮💨 回头看看,是不是审查和重读那一环,正在悄悄吃掉你大半的预算。
链接 · 👇 第一条评论
关注 @svtransit1 · 写给真在用 AI 的人
#AI #AIagent #ClaudeCode #AI编程 #token
原始来源:https://arxiv.org/abs/2601.14470
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS