
AI 把一张图压成一串数字的时候,到底发生了什么?有个开发者动手扒了一下,结果挺反直觉的 🤔
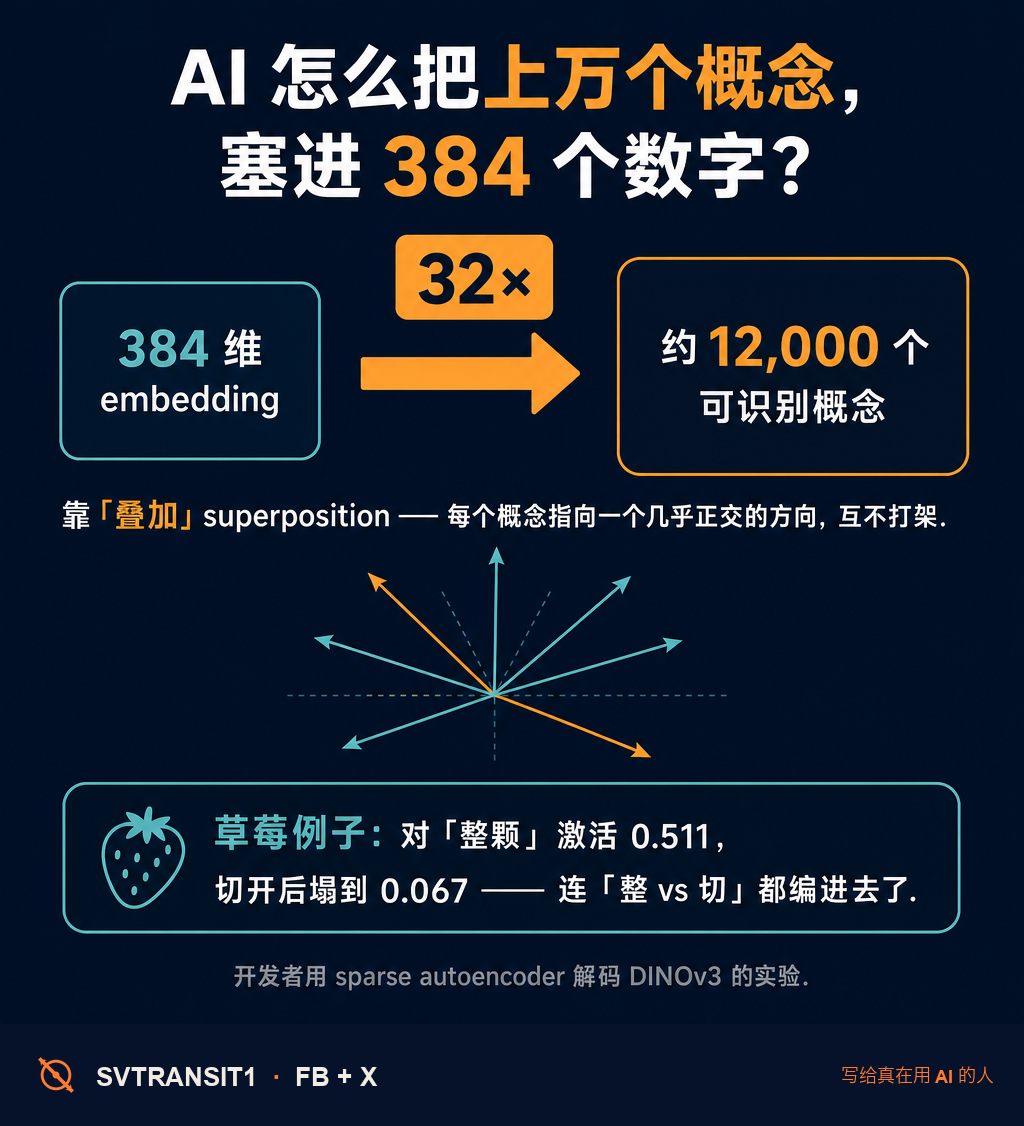
他拿 DINOv3 这个视觉模型的 embedding 来看——一张图,被压成 384 个数字。按常理,384 维顶多也就装 384 个「概念」吧?可他用 sparse autoencoder 一解码,从里头掏出了大约 12000 个能识别的概念方向。整整 32 倍于维度本身。
模型是怎么塞进去的?靠一个叫「叠加」(superposition)的把戏:它不把每个概念单独占一维,而是让每个概念指向一个「几乎正交」的方向——彼此挨得够开、互不打架,于是同样的空间里,能硬塞进远多于维数的东西。
最有意思的是那个草莓例子:有个特征,对「一整颗草莓」激活很强(0.511);可一旦草莓被切开,它立刻塌到 0.067。旁边另一个特征却反过来。也就是说,模型编进去的不只是「草莓」,还有「整的还是切的」「一颗还是一堆」这种细到离谱的区分。
我觉得这事的意思在于:embedding 不是「一维一个概念」那么整齐,而是一团互相叠着的方向。这也正是「可解释性」难搞的根上——模型没把概念摆整齐给你看,你得拿 SAE 这种工具,一点点把它拆出来。换个角度想,这也挺浪漫的:在一个你看不见的高维空间里,上万个概念被巧妙地折叠收纳,挤在区区几百个数字里——你每次调 embedding,背后都是这么一团东西在起作用。
原文链接放在第一条评论 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #可解释性 #embedding #AI原理 #机器学习
原始来源:https://prestonbjensen.com/posts/playing-with-vision-embeddings
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS