
同一批最难的编程题,交给当下三个最能写代码的模型——Claude Opus 4.8、GPT-5.5、Gemini 3.1 Pro 🤖。换一个更狠的判分标准之后,排第一的那个,也只过了一成出头。
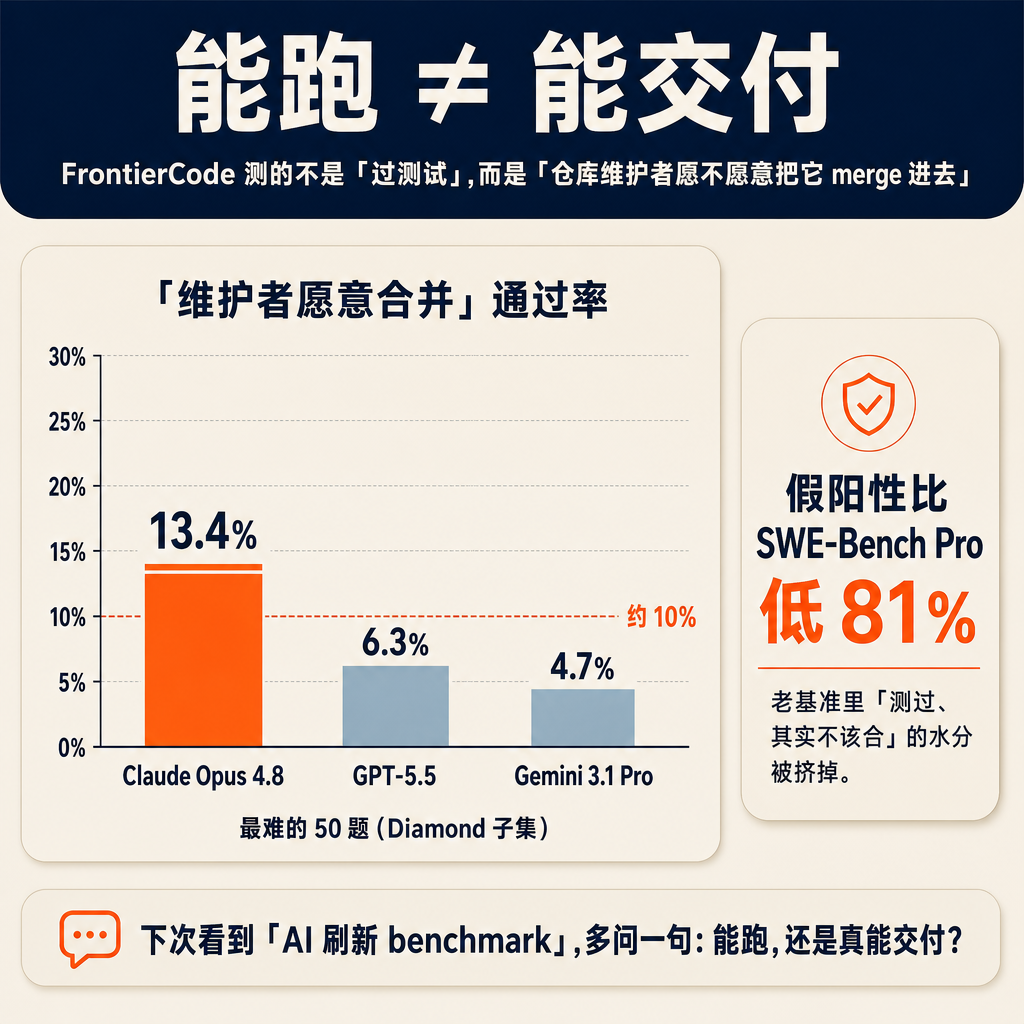
出题的是 Cognition——就是做 Devin 那家。他们的新基准 FrontierCode 把问题换了个问法 🤔:不再问「这段代码能不能跑通测试」,而是问「一个真实仓库的维护者,愿不愿意把它 merge 进去」。它从六个维度打分——行为正确、有没有引入回归、改动干不干净、测试质量、有没有越界、整体代码质量。换句话说,它测的不是「能跑」,是「能交付」。这一换,分数全下来了。
三个模型,我按三条线来比:
第一条线,单点最强 💪。在最难的 50 题(Diamond 子集)上:Opus 4.8 拿了 13.4%,第一;GPT-5.5 是 6.3%;Gemini 3.1 Pro 4.7%。要啃最硬的活、一次就要交付得最干净,Opus 4.8 目前领先得明显——但「领先」也就是过了一成出头,别神化。
第二条线,性价比 💰。这里有反转:GPT-5.5 虽然分低一半,但它用的 token 最多能少到四分之一。也就是说,论「每块钱买到多少能交付的代码」,它未必输——便宜一大截,放到要规模化、跑成千上万次的场景里,有时候比多对几道题更实在。
第三条线,基准本身可不可信 🔍。FrontierCode 比 SWE-Bench Pro 的「假阳性」低了 81%。假阳性就是「测试过了、其实根本不该合」的那种——老基准会把它们算成功,刷出虚高的分;新基准用了反向测试、范围约束这些更严的评分,把水分挤掉了不少。说白了,你过去看到的那些漂亮高分,有不少其实是被假阳性撑起来的。
那到底该选谁?要单点最强、最难的任务、对交付质量零容忍——Opus 4.8。要规模化、成本敏感、能接受单点弱一点——GPT-5.5 的性价比可能反超;真要批量跑,省下的那四分之三 token,比榜单上多过几道题更能落到账上。Gemini 3.1 Pro 这一轮在这条「能交付」线上暂时垫底。
两条得讲清楚 ⚠️:第一,13.4% 是「最难的 50 题」上的成绩,整体分会高不少,别读成「AI 写的代码只有 13% 能用」。第二,这基准是 Cognition 自家做的,他们也做 coding agent,有利益相关;题目还不公开(防刷题),没有公开榜单。
但抛开谁高谁低,这事最有用的提醒是:「跑通测试」和「能被合进生产」,从来是两回事。下次看到「AI 又刷新某 benchmark」,可以多问一句——它过的,是「能跑」,还是「真能交付」?
转给那个一看到「AI 又刷新某 benchmark」就转发的朋友 👇
链接 · 👇 第一条评论
关注 @svtransit1 · 写给真在用 AI 的人
#AI #ClaudeCode #AI编程 #代码基准 #Opus
原始来源:https://cognition.ai/blog/frontier-code
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS