
一个挺反直觉的发现:让大模型「用图像」来推理,可能比用文字更省 token 🤯。
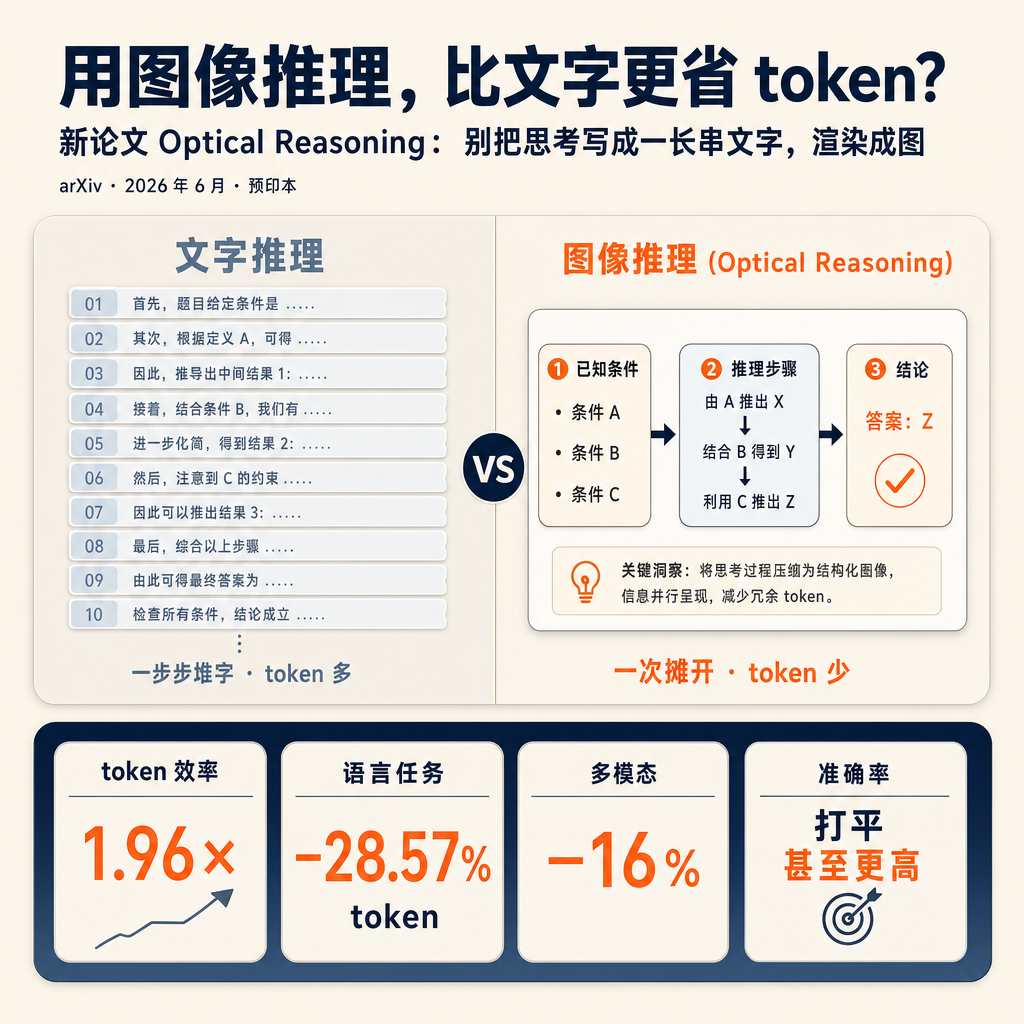
arXiv 上 6 月 8 号挂出的新论文《Optical Reasoning》提了个想法:别让模型把思考过程写成一长串文字,而是渲染成图——要么是紧凑的文字排版,要么是带图形的结构化草稿。
效果是真的省:在数学、科学这类任务上,它的 token 效率是文字推理的 1.96 倍,语言任务平均少用 28.57% 的推理 token,多模态任务省 16%,而且准确率还能打平、甚至更高 📉。
道理也说得通——文字推理只能一个字一个字往下堆,图像却能把空间结构和关系一次摊开,信息密度天然更高。
提醒一句 ⚠️:这是一篇刚挂出来的预印本,数字都是作者自己测的,还没第三方复现,摘要里也没提局限。先当成一个有意思的方向,别急着当定论。
你觉得,未来模型的「思考过程」,会从一行行文字,变成一张张图吗?
原文链接放在第一条评论 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #大模型 #推理 #token效率 #多模态
原始来源:https://arxiv.org/abs/2606.09585
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS