
问个做 agent 的人都遇过的糟心事:为什么一让它上网搜索,token 就哗哗地烧,答得还磕磕绊绊 😮💨?Perplexity 最近放出来的一套东西,给了个挺不一样的解法。
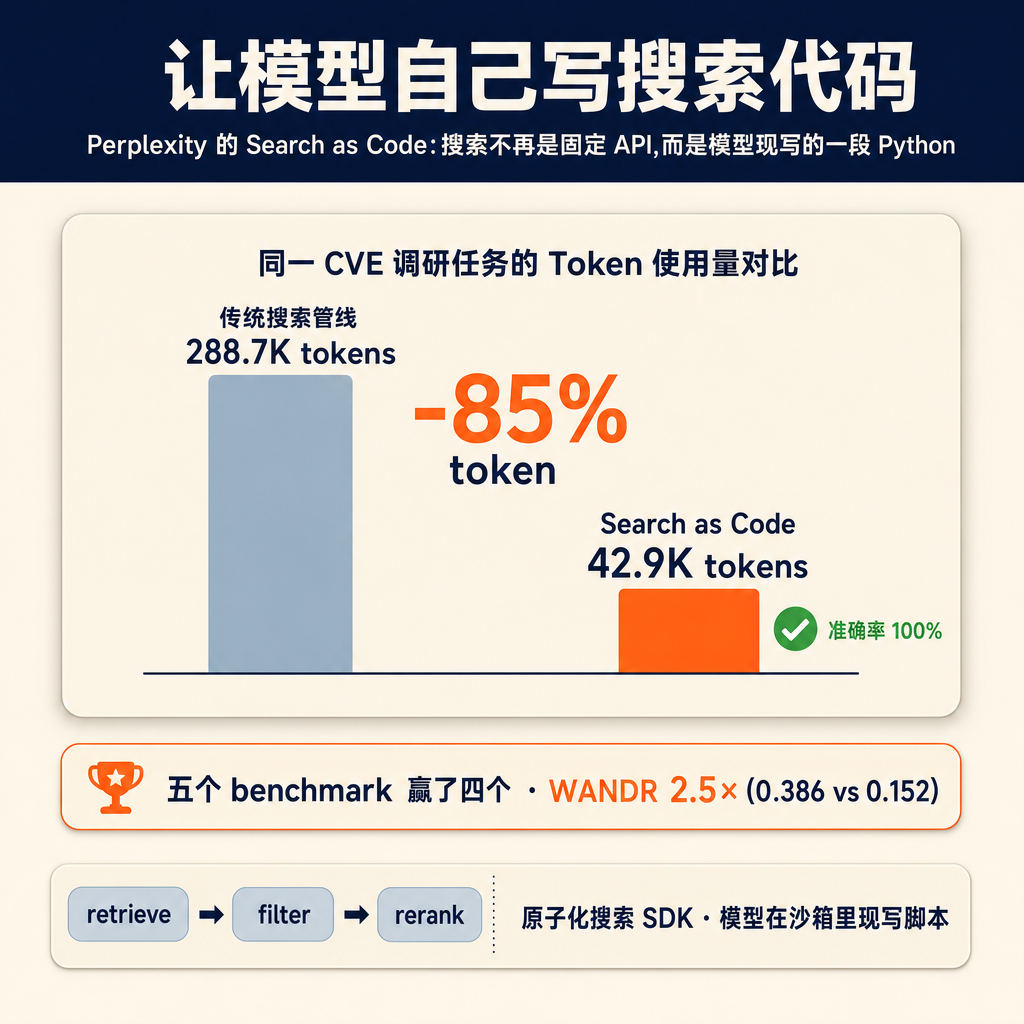
他们管它叫 Search as Code。一句话:别再让模型去「调」搜索 API,让它自己现写一段 Python,把搜索当成代码来编排。
老做法别扭在哪?对模型来说,整个搜索栈就是个黑盒——检索、排序、过滤、去重,全打包在一个固定接口后面。它只能发请求、收结果,没法说「这批我只要近两年的、先去重、再按相关性排一遍」,只能把接口吐回来的一大坨,囫囵塞进 context。用不上的内容也跟着进来,token 就这么烧掉,真正有用的信号反而被淹了。
Search as Code 把这件事拆开:给模型一个「原子化」的搜索 SDK,retrieve、filter、dedup、rerank 这些动作,变成能单独调用的小积木。模型在安全沙箱里现写脚本,自己决定怎么并行查、怎么在程序里就把噪音滤掉。前沿大模型在这儿干的是 control plane 的活——负责指挥,不亲自搬砖。狠的是:一次推理之内,它能跑成千上万次检索 ⚡。
效果有多夸张?拿一个 CVE 漏洞调研的任务做案例:同样的活,token 从 28.87 万砍到 4.29 万,降了 85%,准确率还是满分 100%。对照组里,有些竞争系统连四分之一的数据都没拿全。五个 benchmark 赢了四个,WANDR 这项是次优系统的 2.5 倍(0.386 对 0.152)。
得打个折 ⚠️:这些数字都是 Perplexity 自己报的,而且主要跟自家旧架构、对手系统比,不是中立第三方复现的,别当定论。
但真正值得记的不是分数,是它那个动作:把原本「只能调用的固定能力」,改成「模型可以现写的代码」。搜索只是第一个。还有多少我们习惯塞给 agent 的固定接口,其实都能变成它临场编排的脚本?下次它搜索烧光 token,也许问题不在模型笨,而在你只给了它一个写死的接口,没给它一支笔 🖊️。
这套已经上线在 Perplexity Computer 和它的 Agent API 里了。
完整链接 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #AIagent #Perplexity #AI搜索 #ClaudeCode
原始来源:https://research.perplexity.ai/articles/rethinking-search-as-code-generation
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS