
ChatGPT 把「记忆」这件事,整个换了个做法 🧠。以前是你手动告诉它「记住这条」,攒成一张列表;现在,它自己在后台「做梦」,把你过去几年的对话读一遍,自己综合出该记什么。
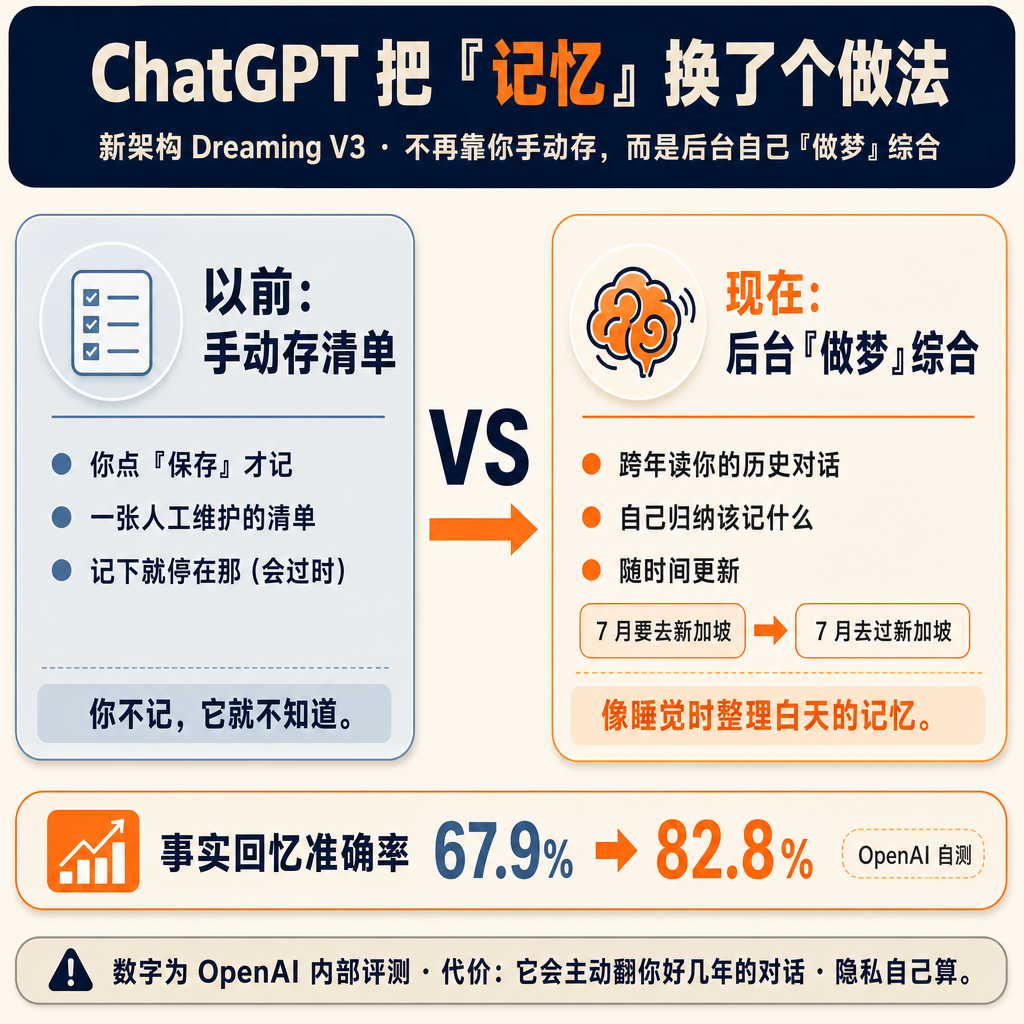
这套新架构叫 Dreaming V3,6 月 4 号开始先推给美国的 Plus 和 Pro 用户。新旧两种做法,差别可以拆成三条线来看 👇
第一条,记忆怎么进去。老办法:靠你顺手点「保存」,或者它偶尔主动存一条,本质是一张人工维护的清单,你不记、它就不知道。新办法:一个后台进程跨越好几年的历史对话,不用你提醒,自己归纳更新——更像一个会自己整理笔记的助理,而不是一个等你录入的表格。
第二条,记忆会不会过时。这是老办法最尴尬的地方:它记下「你 7 月要去新加坡」,然后就一直停在那。Dreaming 会随时间更新——等你回来了,它会把这条改成「你 2026 年 7 月去过新加坡」。记忆从一张快照,变成了一条会自己往前走的状态。
第三条,你能不能管得到。新版给了一个能读的「记忆摘要页」,你能直接看到它到底综合出了你哪些事,能手动加、能改,还能设定哪些话题它该主动提、什么时候提。比起以前那张黑箱清单,至少把「它记了什么」摊开了一点。
不过这里也藏了个新麻烦:你能看到「它记住了什么」,却越来越难看清「它是凭哪几次对话、怎么推出来的」。老办法虽然笨,但每条记忆基本能对上一次明确的「保存」动作;Dreaming 这种后台综合,是把一堆对话揉成一个结论,中间那条「为什么」的链路,反而变淡了。说白了,「做梦」这个比喻挺贴切——它像人睡觉时整理白天的经历,你醒来记得结论,却讲不清是怎么梦出来的。
效果上,OpenAI 给的数字是:事实回忆的准确率,从 2025 那套的 67.9%,提到了这套的 82.8% 📈。一句话,它确实更记得住你了。
那到底好不好?如果你常年用同一个 ChatGPT、希望它越用越懂你,这套自动综合显然省心得多,该选新的。但有两点得拎清楚 ⚠️:一,67.9% 到 82.8% 是 OpenAI 自己内部测的,不是第三方复现;二,这套的代价是,它会主动去翻你好几年的对话来「综合」——越懂你,也意味着它读得越多。隐私这本账,得你自己算。目前是先给美国的 Plus、Pro 用户,之后再慢慢铺到更多地区、免费档和企业版。
抛开 ChatGPT 本身,这事更大的信号是:AI 的「记忆」正在从「你手动喂」转向「它自己后台综合」。这对做 agent 的人也一样——你给 agent 设计记忆,是继续维护一张可控、可追溯的清单,还是放手让它自己归纳?省心和可控,往往得二选一。
说到底,你会希望你的 AI,自己在后台一点点把你「读」得越来越透吗?省心,还是留一手,你站哪边?
完整链接 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #ChatGPT #OpenAI #AI记忆 #个性化
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS