
做 agent 检索的人,最近都在纠结一件事:到底该上向量 embeddings,还是直接拿 grep 搜文本就够了 🤔?
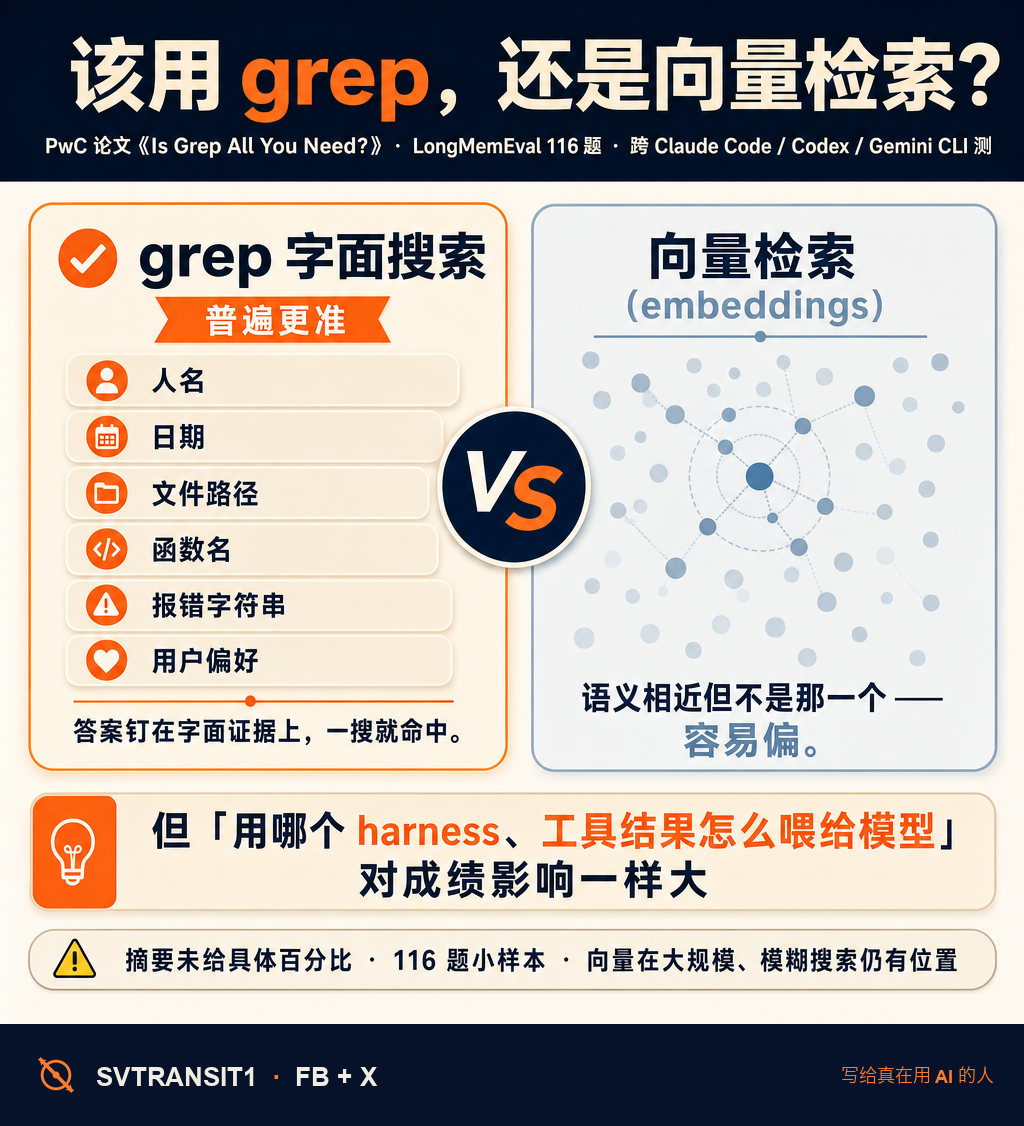
一篇来自 PwC 的论文《Is Grep All You Need?》,给了个不太给 RAG 面子的答案。
他们的做法是这样:在 LongMemEval(一个长记忆问答基准)上抽了 116 道题,跨好几个 agent 框架来测——自研的 Chronos,加上 Claude Code、Codex、Gemini CLI 这些自带命令行的。比的就是「grep 字面搜索」对「向量检索」。
结论挺直接:在他们的实验里,grep 普遍比向量检索更准 📊。道理也好懂——当答案是钉死在字面证据上的(人名、日期、文件路径、函数名、报错字符串、用户偏好),grep 一搜就命中;向量检索反而容易因为「语义相近但不是那一个」而偏掉。
但还有个同样重要的发现:成绩高低,跟你用哪个框架、工具结果怎么喂给模型,关系极大。同样一份数据,换个 harness、换个「直接塞进对话」还是「写进文件让模型自己读」,分数能差出一截。换句话说,「用 grep 还是向量」未必是最关键的那个变量,「你的 agent 到底怎么调工具」可能才是。
这其实也印证了 Claude Code、Cursor 这些工具一直以来的选择——它们本来就更爱 grep、ripgrep,而不是先吭哧吭哧建一套向量库。
得说清楚 ⚠️:论文摘要里并没给具体百分比,只说了「grep 普遍更准」;而且这是 PwC 一家、116 道题的小样本,别急着喊「RAG 已死」。向量检索在大规模、模糊的概念搜索上,仍然有它不可替代的位置。
那轮到你:给 agent 做检索,你是先上向量库,还是先让它 grep?
链接 · 👇 第一条评论
关注 @svtransit1 · 写给真在用 AI 的人
#AI #AIagent #ClaudeCode #RAG #检索
原始来源:https://arxiv.org/abs/2605.15184
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS