
AI agent 现在到底能干多少真实的工作?一个新基准给的答案,有点扎心 😬。
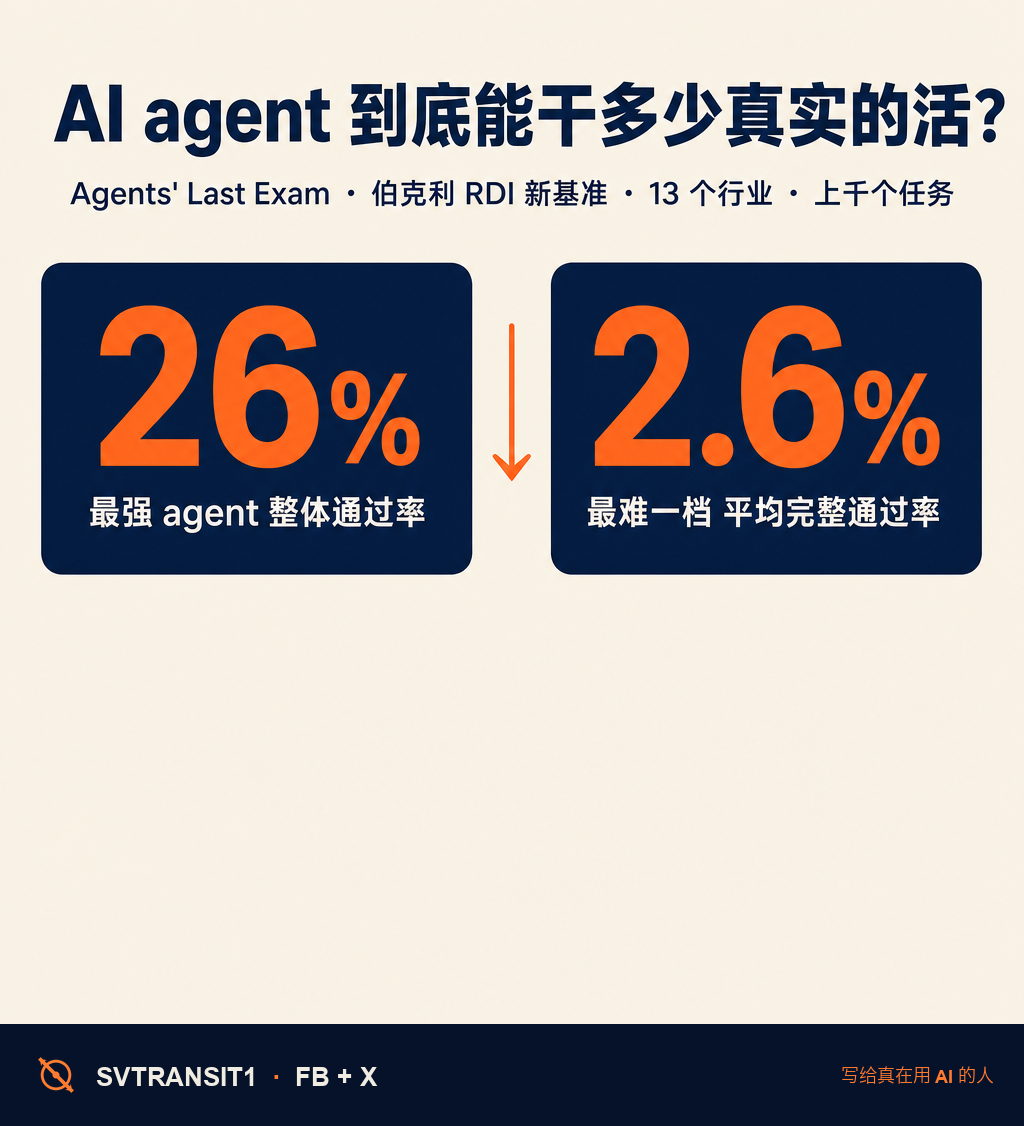
伯克利 RDI 联合 250 多位行业专家,做了个叫 Agents’ Last Exam(ALE)的基准。它不考刷题、不考 demo,专门考「真实、而且能赚钱」的活——覆盖 13 个行业大类、55 个细分领域,上千个任务。
具体到什么程度?它真让 agent 去 Siemens NX 里建 3D 模型、在 Unreal 引擎里搭场景、用 After Effects 做特效合成这类活儿。而且没有人工打分——交付物全部由代码自动核验,跑不通、对不上,就算没过 🔧。
结果是这样的:目前最强的 agent,整体也只通过了 26% 的任务;而在最难的那一档(Last-Exam),平均完整通过率只有 2.6% 📉。
它戳的是一个越来越明显的事:这两年 AI 在各种 benchmark 上分数蹭蹭涨,可这些高分,几乎没变成「真能上岗、真能赚钱」。一个原因就是——常用的 benchmark,根本没在「真实、长流程的工作」上持续地测。
ALE 还被做成了一个「活基准」:任务库会随着新行业、新流程不断扩,目前已经上千个,还在持续往上加。
老实说,这味道跟前阵子 Cognition 的 FrontierCode 一模一样:「跑通测试」「benchmark 高分」,离「真能交付、真能上岗」,差着十万八千里。
说清楚 ⚠️:26% 和 2.6% 是 ALE 这一个基准的口径——它由伯克利牵头(算第三方,比厂商自报可信),但也只是一种测法、一种任务取样,别读成「agent 一无是处」。
下次再看到「agent 又在某 benchmark 刷新纪录」,可以多问一句:它过的,是题,还是活?
链接 · 👇 第一条评论
关注 @svtransit1 · 写给真在用 AI 的人
#AI #AIagent #AI基准 #自主智能体 #Agent
原始来源:https://arxiv.org/abs/2606.05405
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS