
我们天天用的大模型,几乎都是"一个字一个字往外蹦"的——前一个词定了,才轮到下一个。Google 刚开源的 DiffusionGemma,换了套完全不同的玩法 🤯。
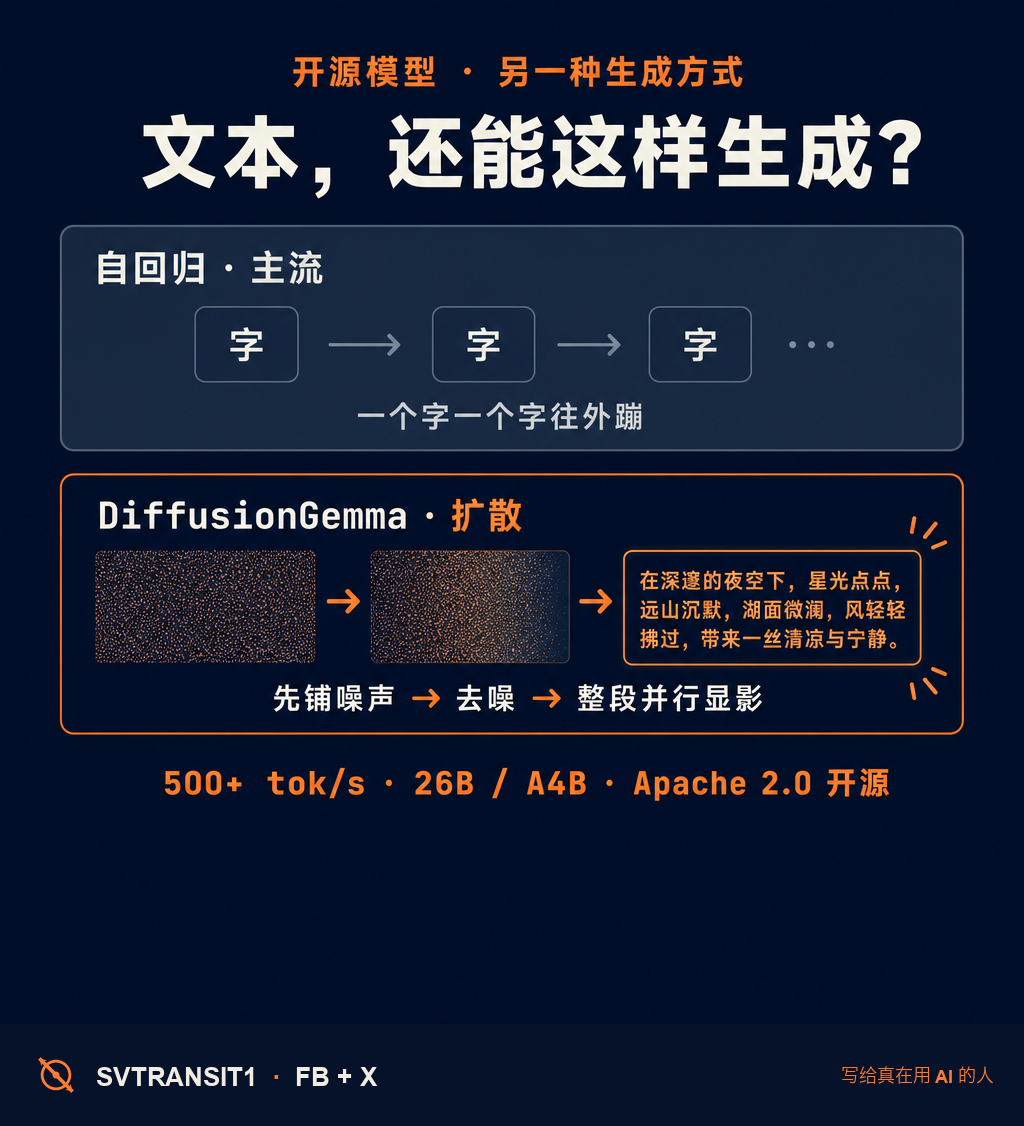
它借的是扩散模型(就是 AI 画图那套)的思路:不从左往右一个个吐,而是先铺一片”噪声”,再一步步去噪,把整段文字像显影一样、并行地”涂”出来。好处很直接——能并行,所以快。Simon Willison 自己拿 NVIDIA 的免费 API 测了一把:4.4 秒吐了 2409 个 token,折合 500+ tok/s,之前的预览版甚至摸到过 857 ⚡。
模型本身 26B(激活约 4B)、Apache 2.0 开源,HuggingFace 直接下,NVIDIA NIM 上还能白嫖跑一跑。
说句公道话 ⚠️:扩散式文本生成还很年轻,质量能不能稳压主流那批”自回归”模型,目前还是个开放问题;500+ tok/s 也是云端单一环境下的数,别当成本地实测。但方向是真有意思——这两年大家拼的都是”同一种生成方式,谁更快”,DiffusionGemma 难得把”另一种生成方式”摆上桌,还开源给你亲手玩。
下一个问题就冒出来了:要是并行生成真能又快又好,那”一个字一个字蹦”,还会是默认答案吗?
原始出处 · 第一条评论拿
关注 @svtransit1 · 写给真在用 AI 的人
#AI #开源模型 #DiffusionGemma #扩散模型 #Google
原始来源:https://simonwillison.net/2026/Jun/10/diffusiongemma/
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS