
想在本地跑视觉模型,最磨人的就是图一喂进去、半天憋不出第一个字。Zyphra 新开源的 Zamba2-VL,把这段等待砍掉了大约九成——靠的不是更猛的显卡,是换了套架构 ⚡。
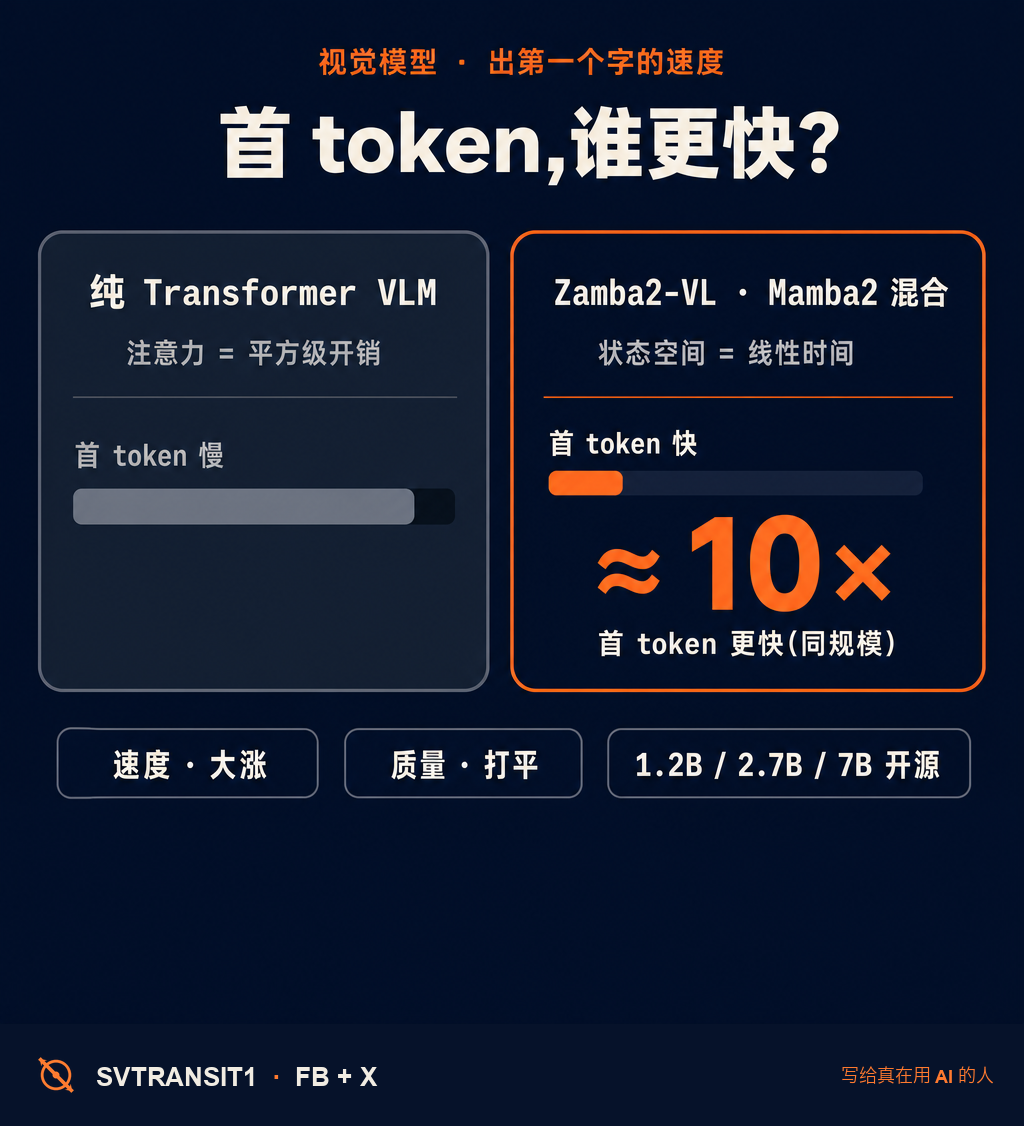
先交代背景。Zamba2-VL 是一套能看图、读字、做推理的视觉-语言模型(VLM),开源放了三个尺寸:1.2B、2.7B、7B,小的那个塞进本地轻松跑。它和主流那批纯 Transformer 的开源 VLM,差别就在底层结构。拿它俩放一起比,差异很清楚:
⚡ 首 token 速度:Zamba2-VL 在同等参数规模下,time-to-first-token 比纯 Transformer 基线低了”大约一个数量级”——这是论文摘要的原话,一个数量级就是十倍上下。这是它最大的卖点。
🎯 质量:打平。在图像理解、推理、OCR、定位、计数这一堆基准上,它跟同规模的主流开源 Transformer VLM 是 competitive(相当)的水平。注意,是持平,不是碾压。
📦 可得性:三个尺寸全开源权重,GitHub 加 HuggingFace 直接下,最小的 1.2B 连消费级显卡都能带得动,本地就能部署。
那它凭什么快这么多?关键在图像 token 太多。VLM 处理一张图,会拆成成百上千个 token,而 Transformer 的注意力是平方级开销:token 翻一倍,这部分计算量就翻四倍,开头那段 prefill 自然被拖得很慢。Zamba2-VL 大部分层换成了 Mamba2——一种状态空间模型(SSM),它不靠”两两 token 互相看”,而是维护一个会随序列滚动更新的状态,所以处理长序列是线性时间;只留一小撮共享注意力头兜底,保住质量。那段最磨人的等待,就这么被压了下去 📉。
所以该选谁?如果你要的是榜单上的最高分,主流大 Transformer VLM 还是稳;但如果你做的是本地部署、长图像输入、要实时响应的活儿,Zamba2-VL 这种”速度大涨、质量持平”的路子,这笔交易很划算。举个具体场景:一个本地跑的截图问答助手,你截一张满屏的图丢进去,首 token 从两三秒压到几百毫秒,那种”它好像秒懂了”的顺滑感,体验完全是两回事。对要把模型嵌进自己应用、又卡在延迟上的人,这点尤其值钱。
说句公道话 ⚠️:十倍这个数,是 Zyphra 自己报的、同规模口径,一种架构、一个指标,别读成”吊打一切”。但 Mamba 这条状态空间的路线喊了挺久,这回总算在视觉模型上,拿出了实打实、能验证的速度优势。
接下来值得盯一眼的是:会不会有更多 VLM 把”纯注意力”换成这种混合架构?真要成了风气,你手上那些跑图像的本地应用,延迟账可能都得重新算一遍。
来源 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #开源模型 #VLM #本地部署 #Mamba
原始来源:https://arxiv.org/abs/2606.00390
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS