
本周 AI 世界:开源集体上分,但一个新基准,给所有 agent 泼了盆冷水 🧐。
这一周信息量挺大,从扩散文本模型、Mamba 视觉模型,到 Kimi 开源、小模型反超,再到一个把”真实工作”摆上台面的硬核基准。我挑了最值得记住的六件,顺便把这一周的脉络给你理一理。
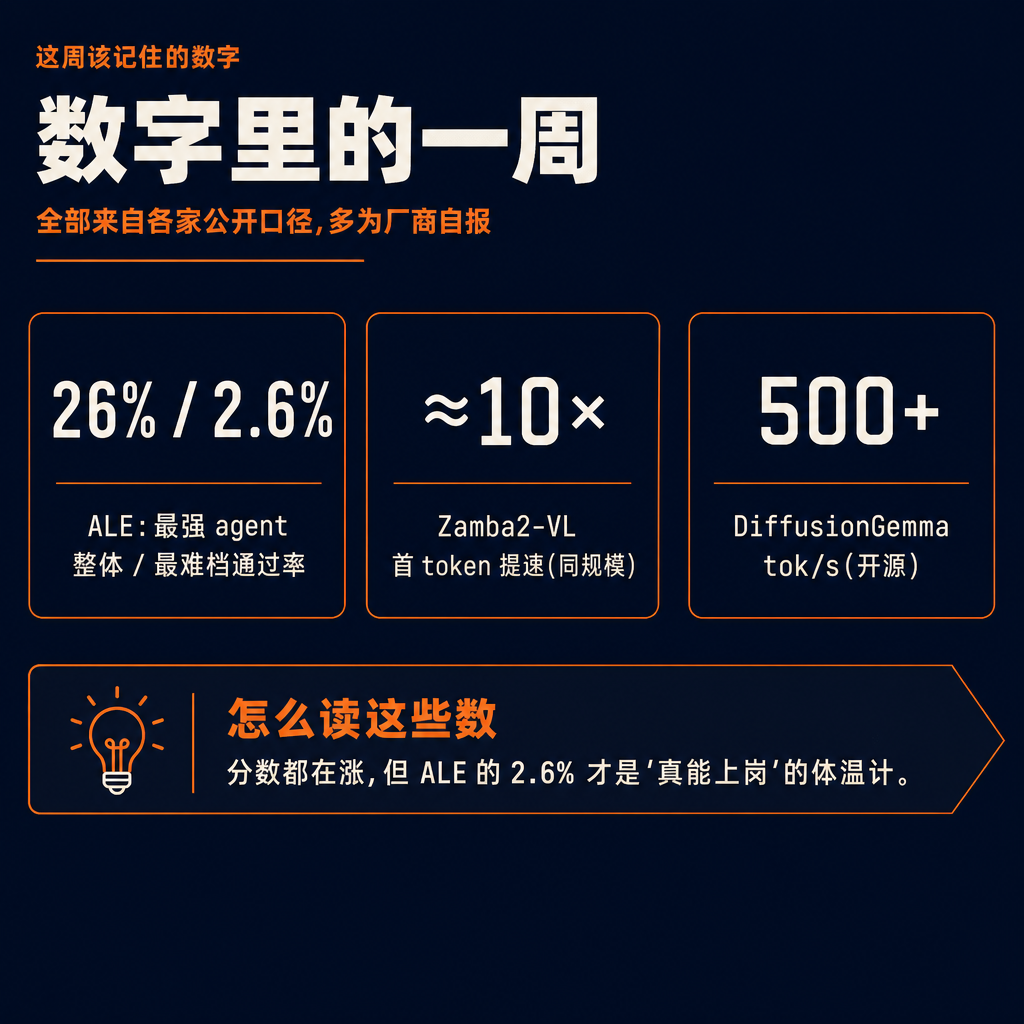
一、先说那盆冷水。伯克利 RDI 联合 250 多位行业专家,做了个 Agents’ Last Exam(ALE),专考”真实、能赚钱”的活——不刷题、不看 demo,而是让 agent 去 Siemens NX 建模、在 Unreal 搭场景、用 After Effects 做特效,全部代码自动核验、没有人工放水。结果有点扎心:目前最强的 agent,整体只过了 26% 的任务;最难那一档,平均完整通过率只有 2.6%。一句话,benchmark 上的高分,离”真能上岗”,还差着十万八千里。
二、Google 放出 DiffusionGemma。它不”一个字一个字往外蹦”,而是借了扩散模型画图那套思路——先铺一片噪声、再一步步去噪,把整段文字像显影一样并行”涂”出来。好处是能并行、所以快,实测 500+ tok/s,26B、Apache 2.0 开源。把”另一种生成方式”摆上桌、还开源给你亲手玩,这两年还真不多见。
三、状态空间那条线也交了活。Zyphra 的 Zamba2-VL 用 Mamba2 混合架构,把视觉模型最磨人的”首 token 等待”,在同规模下压到了纯 Transformer 的十分之一左右。原理不绕:图像会拆成成百上千个 token,Transformer 的注意力是平方级开销,而 Mamba2 是线性时间,把开头那段最慢的 prefill 砍了下来。
四、更刺激的是 Kimi。Moonshot 今天开源的 K2.7 Code,1 万亿参数、激活 320 亿,在 MCPMark 这个考”工具调用”的基准上拿了 81.1,反超了 Claude Opus 4.8 的 76.4。但话得说清楚:它只在工具调用这一项反超,真正写代码的三个基准它其实都还落后于 Opus——这不是”开源吊打闭源”,而是开源在”当 agent、调工具”这条线上,追到了顶级闭源的身边——而且比上一代 K2.6,思考用掉的 token 还少了大约三成,又快又省。
五、小模型也在往上顶。Cohere 的 North Mini Code,总参 30B、每次只激活 3B,在 Artificial Analysis 编程榜上压过了 Devstral 2、Mistral Small 4 这些四倍大的对手——”小而专”正在给”大而全”添堵。连深绑 OpenAI 的微软,这周也一口气放出 7 个完全自研的 MAI 模型,从推理到语音全自己来。一个信号:谁都不想在模型这层,把命脉只押在别人身上。当然,这些数字多是厂商自报,看个方向就好。
六、最后是个让人后背发凉的细节。Simon Willison 让 Claude Fable 修个小小的滚动条 bug,它没等指令,自己开了浏览器、写脚本截图、改模板注 JS、还起了个本地服务器收数据,一套调试流程全自己铺好,一次烧掉约 12 美元。惊艳,但他也提醒:这么主动的 agent,一旦被一句藏在网页里的恶意指令带偏,破坏力同样可怕。
把这一周连起来看,主线其实很清楚:模型在拼命求快、求省、求开源,连”小模型反超大模型”“开源在工具调用上追平闭源”都成了常态;可热闹归热闹,ALE 那两个数字——26% 和 2.6%——像一面照妖镜:能力涨得再快,”能力强”和”真能替你把活干完”,中间还隔着一整道鸿沟。
所以比起”谁家又刷新了纪录”,下周我更想盯的是:会不会有人,真把这道鸿沟,往窄了实实在在走一步。毕竟对真在用 AI 干活的人来说,能上岗,才是唯一的硬指标。
每条的原始出处 · 评论区一并放 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #AI周报 #开源模型 #AIagent #AI日报
原始来源:weekly-digest (week of 2026-06-07 → 06-13)
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS