
「智谱的 GLM-5.2 出了,现在该上车吗?」先别急——它这次发布,干了件挺反常的事 🤔。
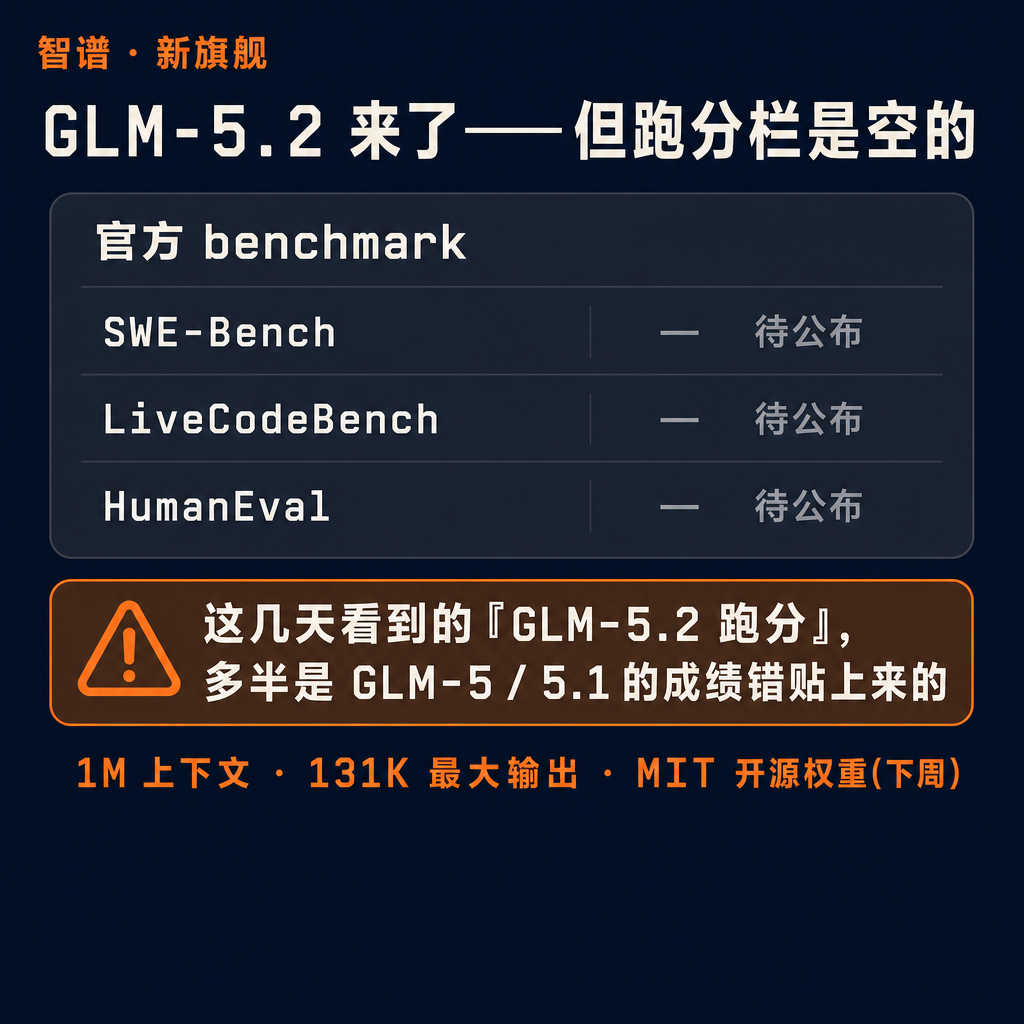
先说它是什么。GLM-5.2 是 Z.ai(智谱)刚发布的新旗舰,主打编程,号称能用满 1M 上下文,单次最大输出 131K token;还分两档思考模式,High 和 Max,写代码官方推荐用 Max。对在 Claude Code 里挂第三方模型的人,有个细节挺实用:low / medium / high 都映射到它的 High,xhigh / max / ultracode 映射到 Max。目前它只在 GLM Coding Plan 各档(Lite / Pro / Max / Team)开放,独立 API 还没上。
反常的地方在这:发布的时候,它一个 benchmark 都没放 📉。Z.ai 直接把模型和编程套餐上线了,没有附任何跑分——SWE-Bench、LiveCodeBench、HumanEval,一个都没有。在这个”发布即刷榜”的年代,一个旗舰模型空着分数栏上线,本身就挺少见。
所以这几天有个坑你得绕开:要是你看到”GLM-5.2 在某榜拿了多少分”这种数字,基本可以默认它是错的。原文说得很直接——这几天贴在”GLM-5.2”名下的任何具体分数,八成都是 GLM-5 或 5.1 的成绩,被错安到了新版头上 ⚠️。
那真本事到底如何?得再等等。官方说,MIT 协议的开源权重、独立 API 和聊天入口,都要下周才上;真正能验证的第三方评测,自然也得等权重开了之后。
所以”该不该上车”的答案挺朴素:你要是已经在用 GLM 的编程套餐,顺手试试没问题;但如果你是”看分数再决定”的那种,沉住气,等一周。
下次再刷到”新模型吊打一切”的跑分,不妨多问一句:这个分,到底是这一代真测出来的,还是上一代的成绩,被悄悄搬过来了?
来源 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #GLM #智谱 #开源模型 #AI编程
原始来源:https://www.digitalapplied.com/blog/glm-5-2-zai-flagship-coding-plan-release
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS