
"省 95% 的 token"——这种标题我现在看到都先打个问号。但 Headroom 这个开源项目(Apache 2.0,已经两万八千多 star)把数据全摊开了,我帮你拆一拆,哪部分是真的,哪部分是挑着说的 🔍。
先说它干嘛的:跑 agent 的人都被 token 账单咬过 💸。一次代码搜索甩进去一万七千个 token,一次线上排障六万多,钱烧得飞快,模型还容易被一堆噪音带跑偏。Headroom 就是夹在你和大模型中间的一层,把 context 压一压再发出去。
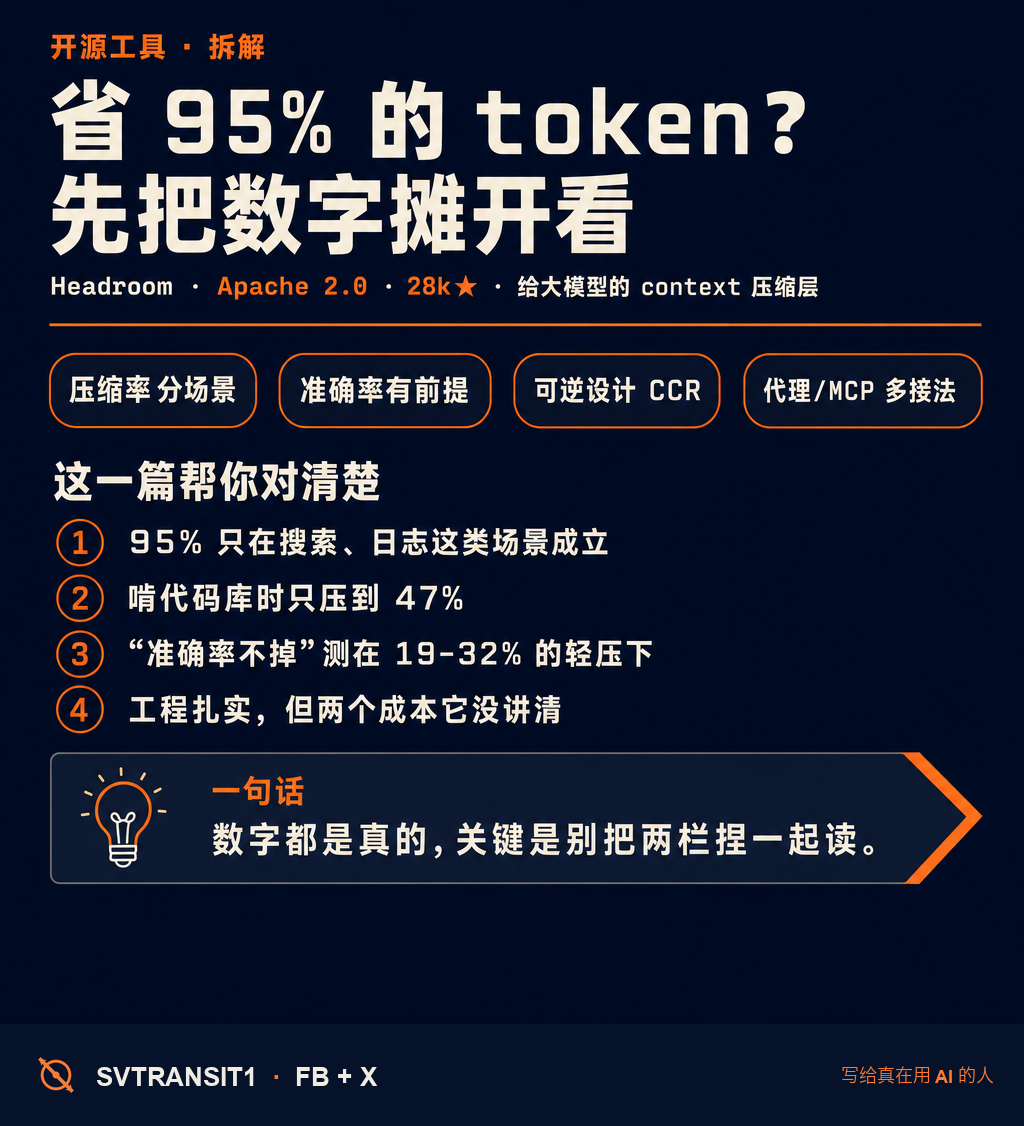
而那个 60% 到 95%,是分场景的,根本不是一刀切:
代码搜索,17765 压到 1408,省了 92%;线上排障的日志,65694 压到 5118,同样 92%;GitHub issue 整理降到 73%;可真要它去啃整个代码库做探索,只压到了 47%。规律很清楚——越是重复、噪音多的东西(搜索结果、日志),压得越狠;越是本来就密的代码,它越下不去手。所以官网那行”95%”,是拿最理想的场景在说话。
更得小心的是”准确率没掉”这句 ⚠️。它的 benchmark 是真的:GSM8K 数学题 0.870 压完还是 0.870,一分没丢;TruthfulQA 甚至从 0.530 涨到 0.560(压掉噪音反而少被带偏,这个我信)。但再往下翻,SQuAD、BFCL 这些拿到 97% 的测试,对应的压缩率只有 19% 和 32%——跟前面那个 92% 完全不是一档力度。
这就是最容易被误读的地方:”狂压 92%”和”准确率几乎不掉”,是在两种不同力度下分别测出来的,不能捏一起读。它没骗人,数字都摆着,但你得自己把这两栏对上,才不会高估它。
工程本身做得挺扎实。压缩拆成了好几个零件:SmartCrusher 啃各种 JSON,CodeCompressor 是按语法树来的,Python、JS、Go、Rust、Java、C++ 都认;还有个 CacheAligner,专门保证压完之后 Anthropic、OpenAI 那边的 KV cache 还能命中——不然你省了 token,却把缓存折腾废了,等于白省。我觉得最实用的是 CCR 那个可逆设计:原文存在本地,模型真要细节时自己调 headroom_retrieve 去取,等于压缩之外还留了条后路。
接法也不挑:当库直接 compress、当代理零改代码、一句 headroom wrap claude / codex / cursor 把现成 agent 包起来,或者挂成 MCP server,LangChain、LiteLLM、官方 SDK 都接得上。
老实说,有两个坑它没填:CCR 回头取原文那一下,额外多少钱、多少延迟,没给数;那个专门训出来的压缩模型,用的”agentic traces”是哪来的,也没说。这两点不清楚之前,我不会把它直接糊进生产链路。但拿来给搜索、日志这种”水分大”的环节减负,看着是真能省钱。
转给那个天天盯着 token 账单皱眉的同事 👇
完整链接 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #Headroom #ClaudeCode #token #AI工具
原始来源:https://github.com/chopratejas/headroom
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS