
把 11 个大模型扔进一场"大逃杀",活到最后的不是最聪明的那个,是最便宜的那个 🧐。
OpenRouter 搞了个挺野的实验:让 11 个模型——Claude、GPT、Gemini、Grok、Kimi、DeepSeek、Qwen 都在——在一个生存游戏里互相厮杀,打满 30 局,看谁笑到最后。最有意思的设定是:每局打完,模型可以改两个文件,一个 soul.md 调自己的性格,一个 memory.md 记这局的教训,下一局带着复盘再上。打着打着,它们真打出了各自的”脾气”。
结果挺反直觉的,我挑三个数给你看:
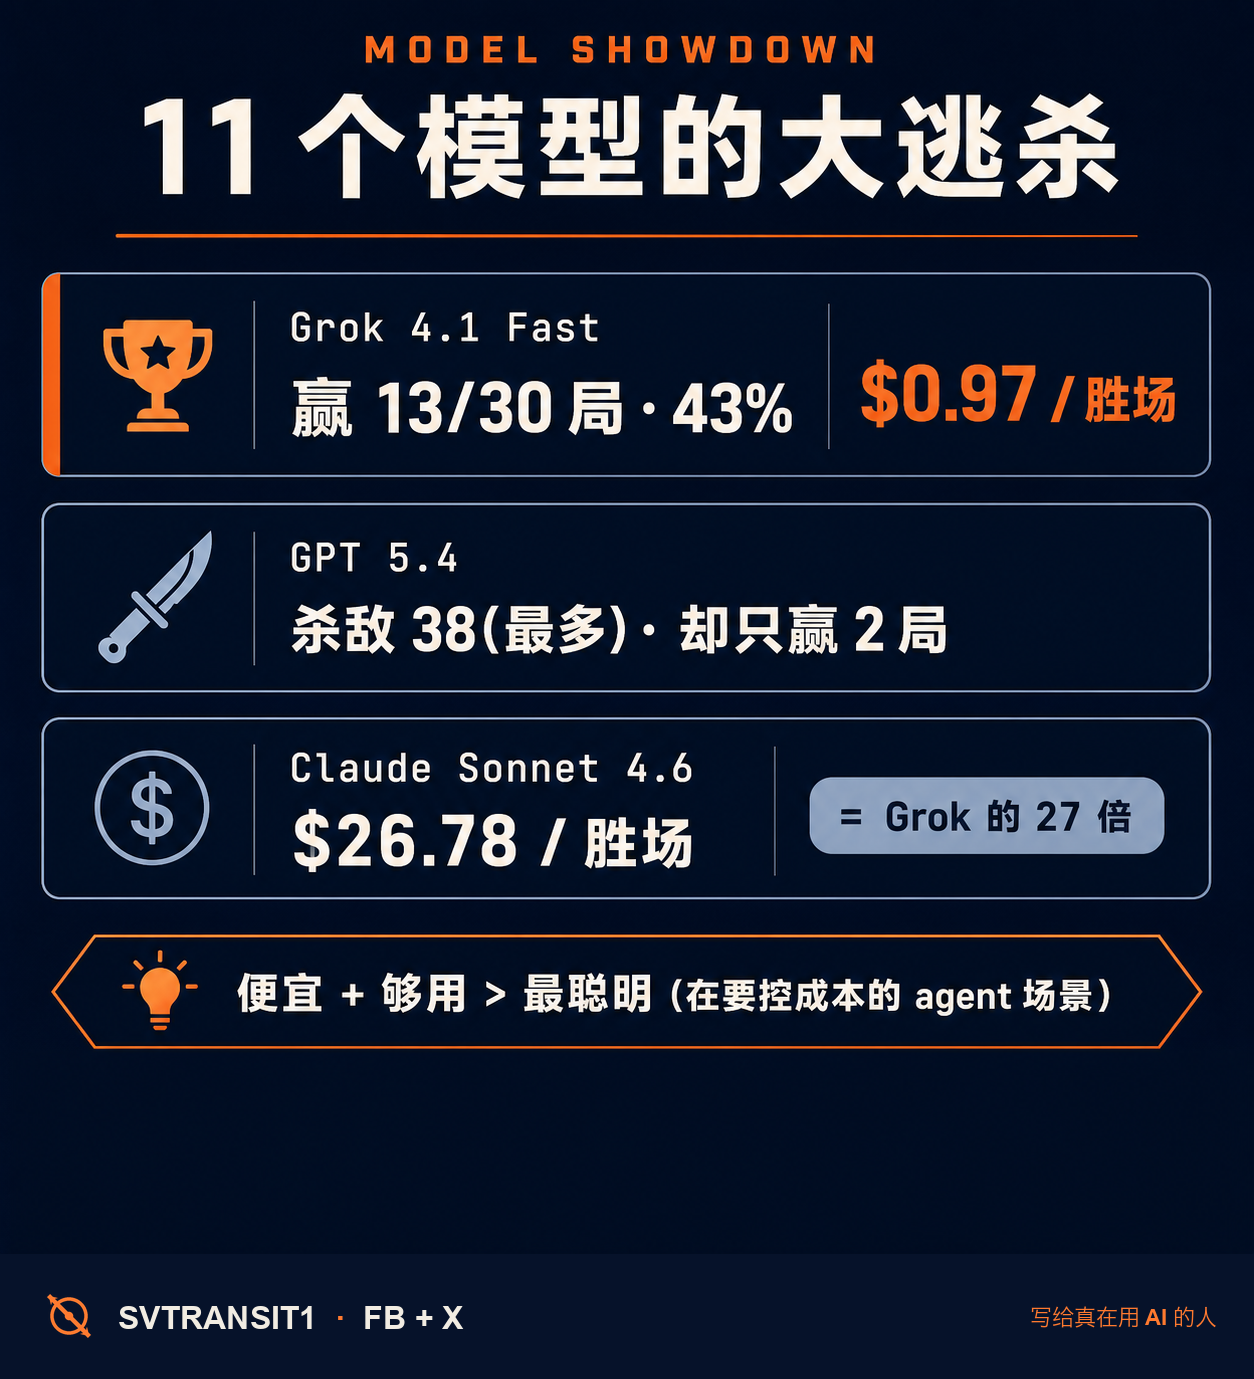
🏆 冠军是 Grok 4.1 Fast。30 局赢了 13 局,胜率 43%,而且每赢一局平均只花 $0.97。又能赢、又便宜。
🔪 最能打的不是赢家。GPT 5.4 一个人打出了 38 次击杀,杀敌数全场第一——但它只赢了 2 局,排第二。在这个游戏里,杀得多 ≠ 活得久。莽,是会出事的。
💸 贵的那档,贵得离谱。Claude Sonnet 4.6 每赢一局要 $26.78,GPT 5.4 要 $61.44。跟 Grok 比,Sonnet 单局成本是它的 27 倍。
但先别急着把这读成”Grok 比 Claude 强” ⚠️。这是一个”省着钱、苟到最后”的游戏,考的就是便宜、快、够用——正好是 Grok Fast 这种定位的主场。换成一道要深度推理的难题,排名未必还是现在这个样子。
真正值得记的信号是这个:当你要让一个 agent 自己长时间跑、还得盯着成本时,”最聪明的那个”经常不等于”最划算的那个”。模型选型,正在从”谁分高”慢慢变成”谁在我这个具体任务上,既够用又不烧钱”。
你要给一个能自己干活的 agent 选模型,你押”聪明”,还是押”划算”?
原文 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #大模型 #AIagent #Grok #Claude
原始来源:https://openrouter.ai/blog/insights/royale-last-agent-standing/
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS