
一个 3B 的小模型,数学推理居然摸到了几百倍大的模型的边——但先别急着喊"平替" 🧐。
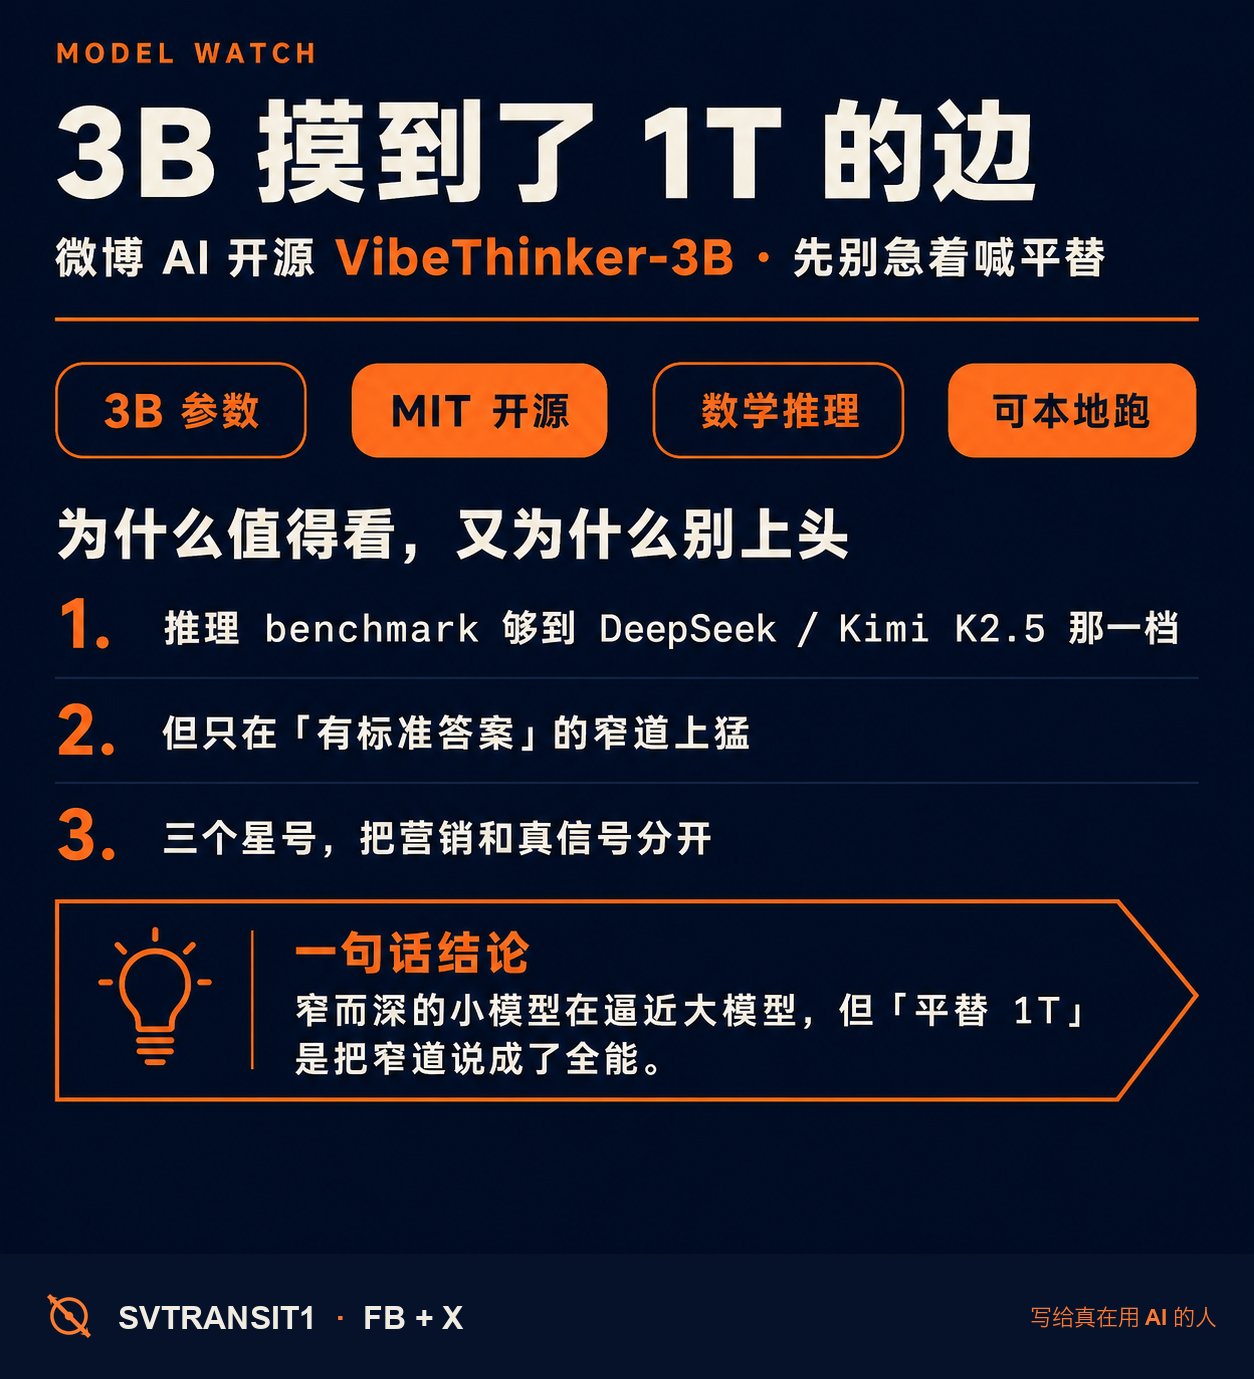
微博 AI 刚开源了 VibeThinker-3B(MIT,基于 Qwen2.5-Coder-3B,权重已经放出来了)。最唬人的一句话是:在推理 benchmark 上,它逼近了 DeepSeek V3.2(671B)、GLM-5(744B)、Kimi K2.5(1T)那一档。3B 对 1T,体量差了三百多倍。
数字也确实硬 💪:IMO-AnswerBench(400 道 IMO 级别的题)考了 76.4;最近一个多月的 LeetCode 周赛和双周赛,没见过的新题,接受率 96%。在 3B 这个量级,这是真能打。
但我得把三个星号摆出来 ⚠️:
一,它只在”可验证的推理”这条窄道上猛——数学、竞赛题这种有标准答案的活。开放域的杂学知识,官方自己都说”大模型还是更合适”。
二,它根本不碰工具调用和 agent——这不是没练出来,是压根没往这个方向做。官方明确写着:别拿它做 function calling、API 编排、自动编码 agent。所以你日常那套 agent 工作流,它接不上。
三,被传得最凶的那个”80.6 分”,用了一个叫 CLR 的测试时技巧,而拿来对比的大模型没开这招。拉平了看,76.4 对 DeepSeek 的 78.3,只能算贴脸,谈不上反超。
所以真实信号是这个:小模型在”窄而深”的专项上,正越来越逼近大模型——这条线很要紧,因为本地能跑、便宜、还快。可”3B 平替 1T”这种说法,是把一条窄道的成绩,说成了全能,营销味太冲。
你会为了”数学推理”这一个长板,在本地常驻一个 3B 吗?还是宁可留着那个啥都能凑合干的大模型?
原文+论文 · 评论区取 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #小模型 #推理模型 #开源 #本地LLM
原始来源:https://huggingface.co/WeiboAI/VibeThinker-3B
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS