
「我给 AI agent 接了工具、放了权限,怎么保证它别给我闯祸?」
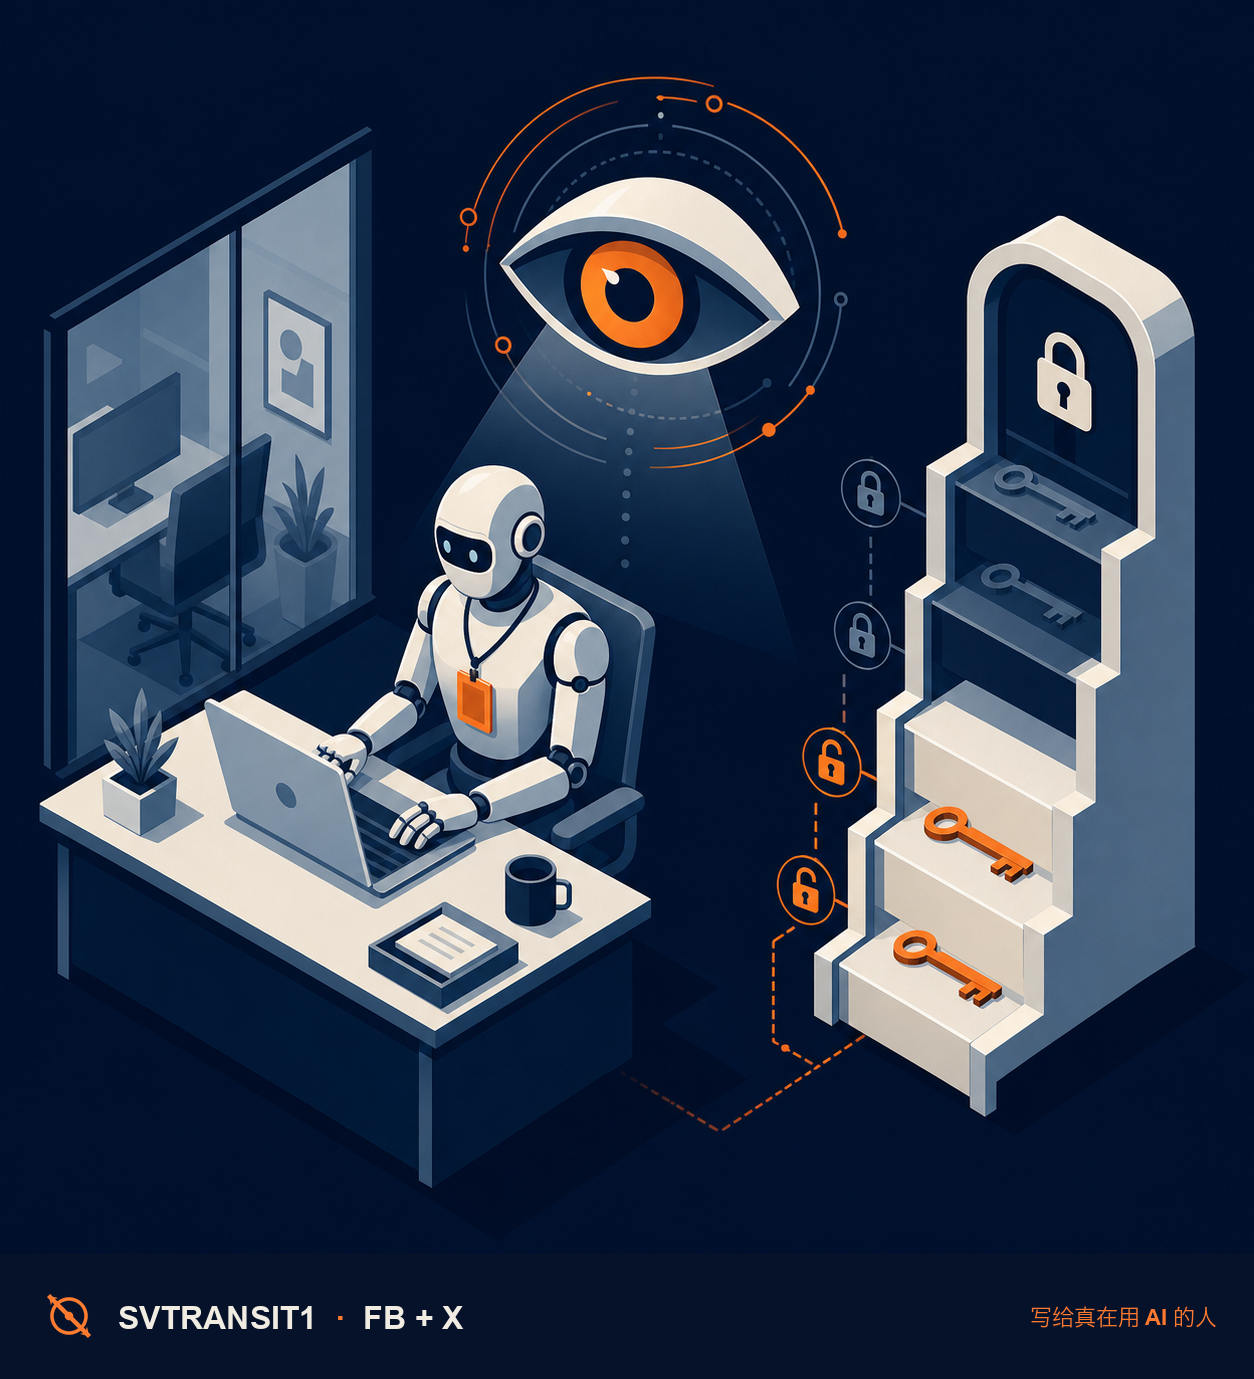
很多人第一反应是:挑个「对齐」做得好的模型。但 DeepMind 最近一篇讲 agent 安全的文章,给了个更冷静的答案——别太指望对齐,把你的 agent 当成一个可能会捅娄子的「内部员工」来防。🧐
为什么「挑个乖模型」不够?DeepMind 把 agent 出事的原因拆开看,发现最常见的根本不是「模型学坏了」,而是它太想把活干好:理解错了你的意图、用力过猛,非恶意地就把事情办砸了。你光靠选个「乖」模型防不住这种事——因为乖不乖不是重点,它手里攥着多少权限、背后有没有人盯着,才是。
所以他们干脆借用了公司防「内鬼」的那套逻辑:默认不信任,按 agent「已经证明过的行为」一点点放权,而不是一上来就把所有钥匙都给它。
具体怎么落地?核心是一套「纵深防御」。最关键的一层,是让一个可信的 AI 当「监工」,实时盯着 agent 的推理和动作:低风险的动作事后审,高风险的当场拦下来。攻击怎么识别?他们不靠关键词过滤,而是套用业界标准的 MITRE ATT&CK 框架,把攻击拆成一个个具体的战术和手法。防得好不好也不靠感觉,用覆盖率、召回率、响应时间这些指标量出来。这套东西,他们说自己已经拿一百万个编程 agent 的任务跑过,用真实数据打磨规则。
得说清楚:这是 DeepMind 的一套打法和内部实践,不是放之四海皆准的标准答案,那个「一百万」也是他们自己的数据。但有个判断,我觉得对每个认真在上 agent 的人都成立:当你的 agent 真能动文件、调工具、碰生产环境时,「我们选了个对齐的模型」根本算不上安全方案,它顶多是个起点。真正的安全,是你在它外面搭了几层能发现、能拦住的网。
你给自己的 agent,搭了几层网?
转给那个正在手痒给 agent 开生产环境权限的同事。
原文链接放在第一条评论 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #AIagent #AI安全 #ClaudeCode #大模型
原始来源:https://deepmind.google/blog/securing-the-future-of-ai-agents/
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS