
蒸馏——让一个小模型对着大模型学、把本事偷过来——一直有个很多人没注意的隐形天花板:师生俩得用同一个分词器,基本只能在自己家族里教。最近一篇论文(arXiv 2606.09456,《Breaking the Tokenizer Barrier》)把这堵墙捅破了。🧐
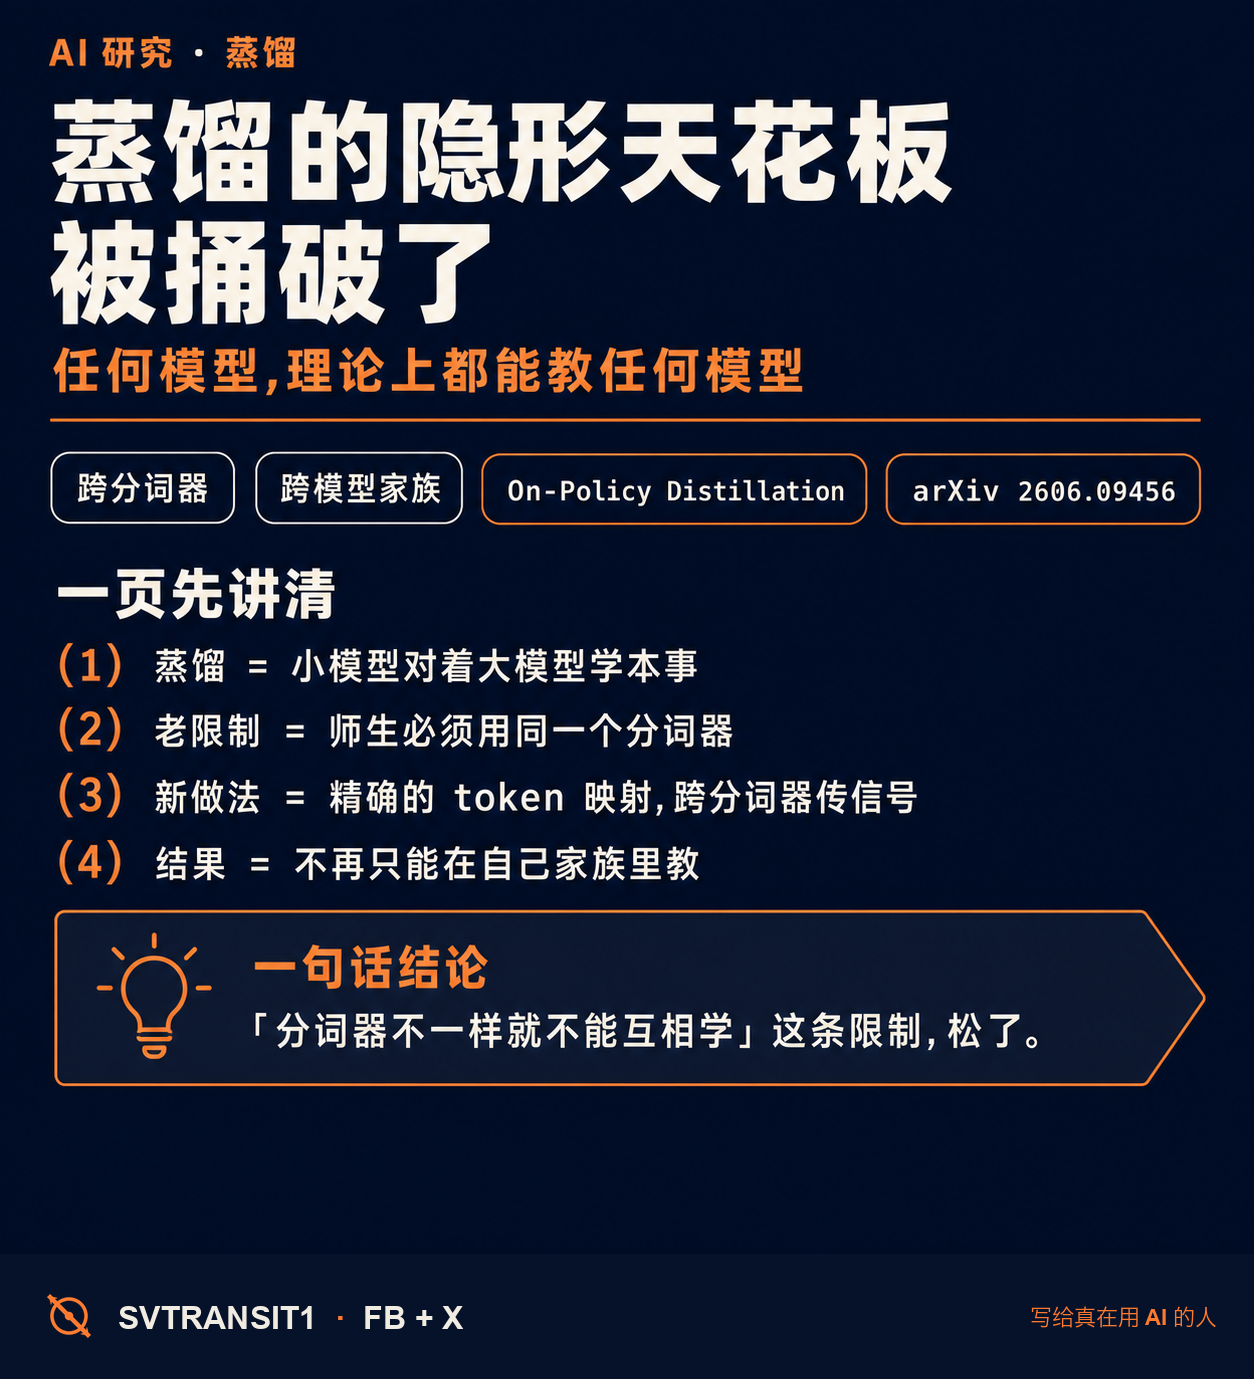
先说人话。便宜又能打的小模型是怎么来的:你让小模型对着大模型的输出学,学的不只是答案,还有大模型在每个 token 上的概率分布(信息量比直接喂标准答案大得多)。但有个硬限制——这套 On-Policy Distillation 要求老师和学生用同一个分词器,所以基本只能 Llama 教 Llama、Qwen 教 Qwen,跨不了家族。这篇论文搞了个「精确的 token 映射」,让这些 token 级的信号能在不同分词器之间传过去。于是,理论上:任何模型,都能教任何模型。
这件事悄悄改了三样东西。
1️⃣ 「分词器」这道隐形的护城河,变浅了
以前不同家族的模型像说不同方言,蒸馏这条捷径走不通。现在方言能互译,强模型的本事更容易被「抽」到别的架构上去。
2️⃣ 小团队能拜更强的老师
你自己跑的那个小模型,以前只能找同门师傅;现在原则上能拜任何一个更强的模型为师,把它的行为学过来。能不能学到精髓另说,但门开了。
3️⃣ 「用谁家分词器」不再是站队的理由
过去选模型,分词器某种程度上是个隐性锁定项——你后面要蒸馏、要兼容,就得顺着它。这层顾虑一松,模型生态会更像一个能互相搬运能力的市场,而不是一个个封闭的院子。
当然得泼点冷水。这是一篇研究论文,不是你现在能用的工具;它说自己「明显更省算力」,但摘要里没给具体数字,得等代码和完整结果出来再下结论。而且「token 映射」本身是有损的——能传多少、保真到什么程度,才是这套方法成败的关键。蒸馏还有个绕不开的灰色地带:从别人家的闭源模型里蒸,可能踩人家的使用条款。
但方向我觉得挺重要:它提醒你,很多看着很硬的「壁垒」,其实是某个工程选择的副产品,不是物理定律。「分词器不一样就不能互相学习」——这条一旦不成立,模型之间「谁能向谁学」的版图,可能要重画。
能力能更自由地在模型之间流动,你觉得对开源这边是好事,还是反而会让闭源模型更不敢开放?
原文链接放在第一条评论 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #大模型 #模型蒸馏 #开源AI #LLM
原始来源:https://arxiv.org/abs/2606.09456
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS