
「浏览器里跑 embedding、一个 API 都不调,真能替掉云端那套吗?」
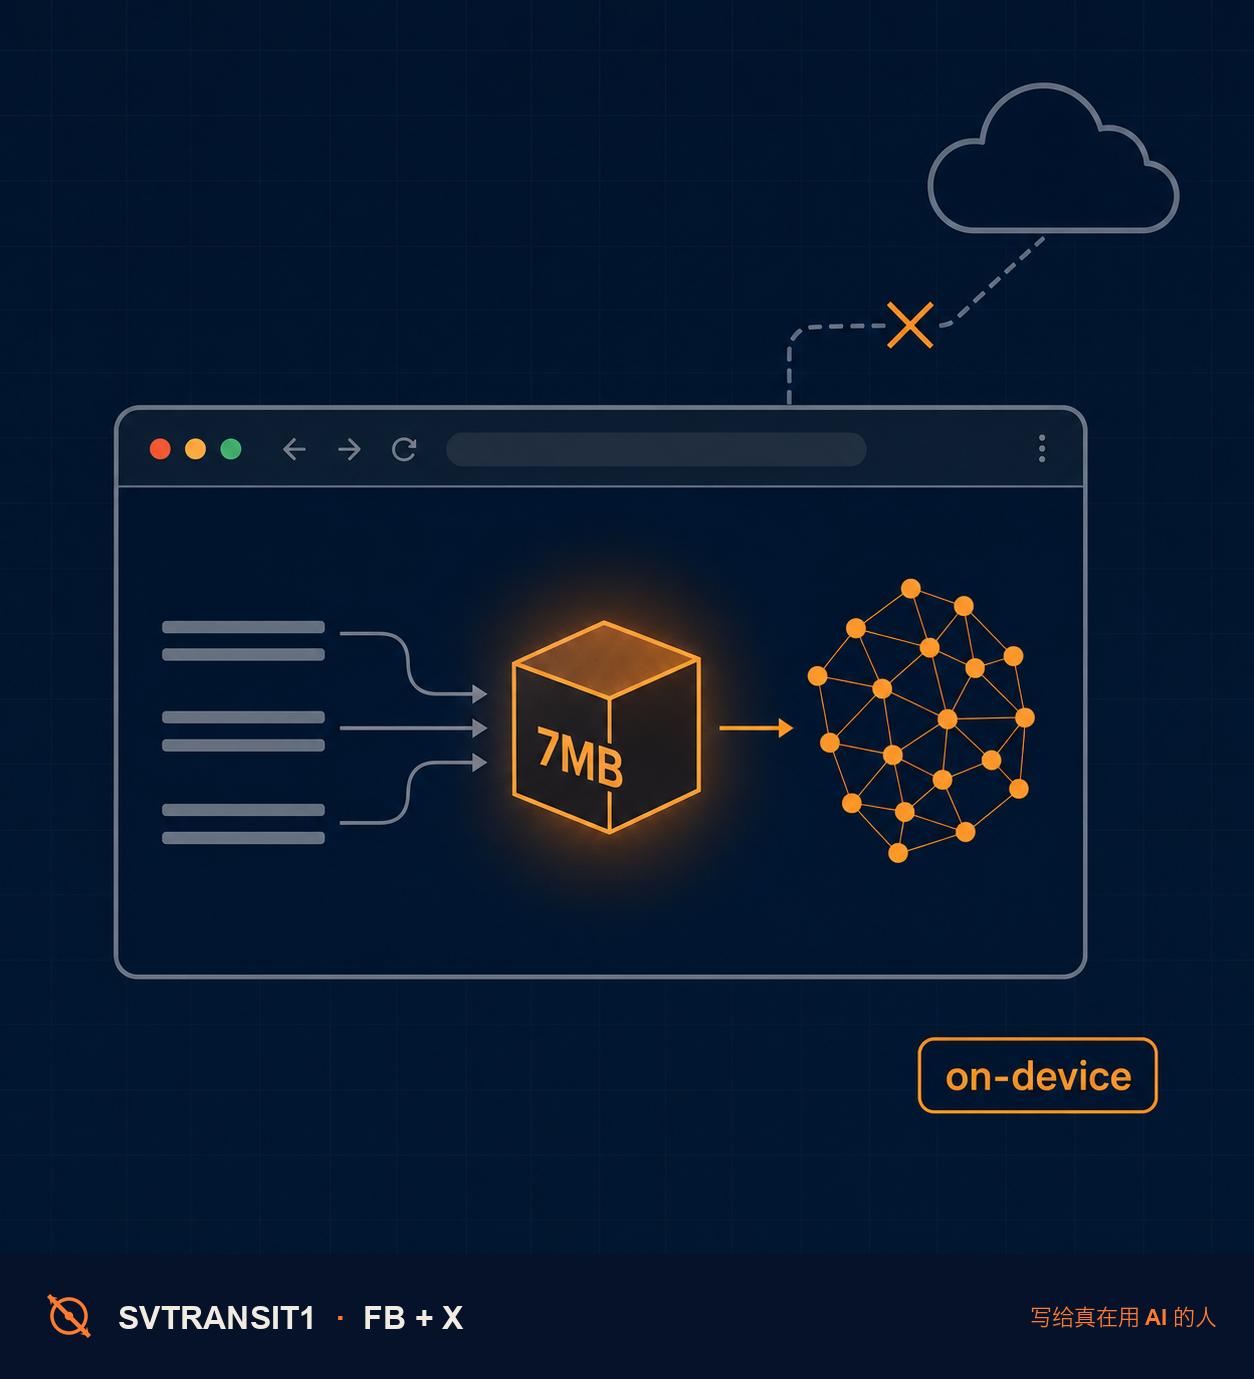
对一大类场景,能。但大多数人第一反应是「7MB 能有什么用」或者「本地肯定慢到没法用」——方向就错了。有个叫 Ternlight 的东西,是个 7MB 的 embedding 模型,直接在浏览器 WASM 里跑,把文本变向量这件事整个搬到了本地:不联网,不调 API,用户的数据一个字都不出他自己的浏览器。短答案是——够不够用,不看模型多大,看你的场景吃不吃得下「有损精度」。
先说它凭什么能塞进 7MB。它把权重做成三值(ternary),每个权重只有 -1、0、+1。更狠的是训练方式:模型从第一步就按三值(QAT 量化感知训练)来训,所以那 0.84 的保真度是实打实「学」出来的——后期硬压根本压不出这个数。推理引擎用 Rust 编成 WASM 带 SIMD,浏览器和 Node 都能跑,零依赖。两个档:base 7MB、每次约 5 毫秒;mini 5MB、2.5 毫秒,输出 384 维向量。作者连训练代码一起开了(MIT),不是甩个权重跑路。
那什么时候能上、什么时候别碰?纯前端的语义搜索、FAQ 匹配、意图识别——离线能用、免费、数据不出浏览器,它接得住。但它是从 MiniLM-L6 蒸馏来的,0.84 保真意味着有能感觉到的精度损失(MiniLM 本身在 MTEB 也就中游 ~56 分;和 gte-small ~61 的对比,作者说还没实测,先别当定论)。要做高精度 RAG,它替不了云端。还有坑:性能很吃 SIMD——有人在老 i5 上没走 SIMD,速度从 ~400 掉到 35 emb/秒;Safari / Apple Silicon 目前已知是坏的,作者自己认了。
比这一个模型更有意思的是它指的方向:embedding 这层,一直被默认成「必须付费上云」的基础设施。Ternlight 至少证明了,对一大类活,它完全可以跑在本地——免费、私密、不出端。你手上那些 RAG,有多少其实根本不需要那个 embedding API?
原文链接放在第一条评论 ↓
关注 @svtransit1 · 写给真在用 AI 的人
#AI #LocalLLM #RAG #AI工具
原始来源:https://github.com/soycaporal/ternlight
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS