
「为什么有的模型,你就是觉得它『更聪明』?」——可能跟它到底聪不聪明,关系不大。
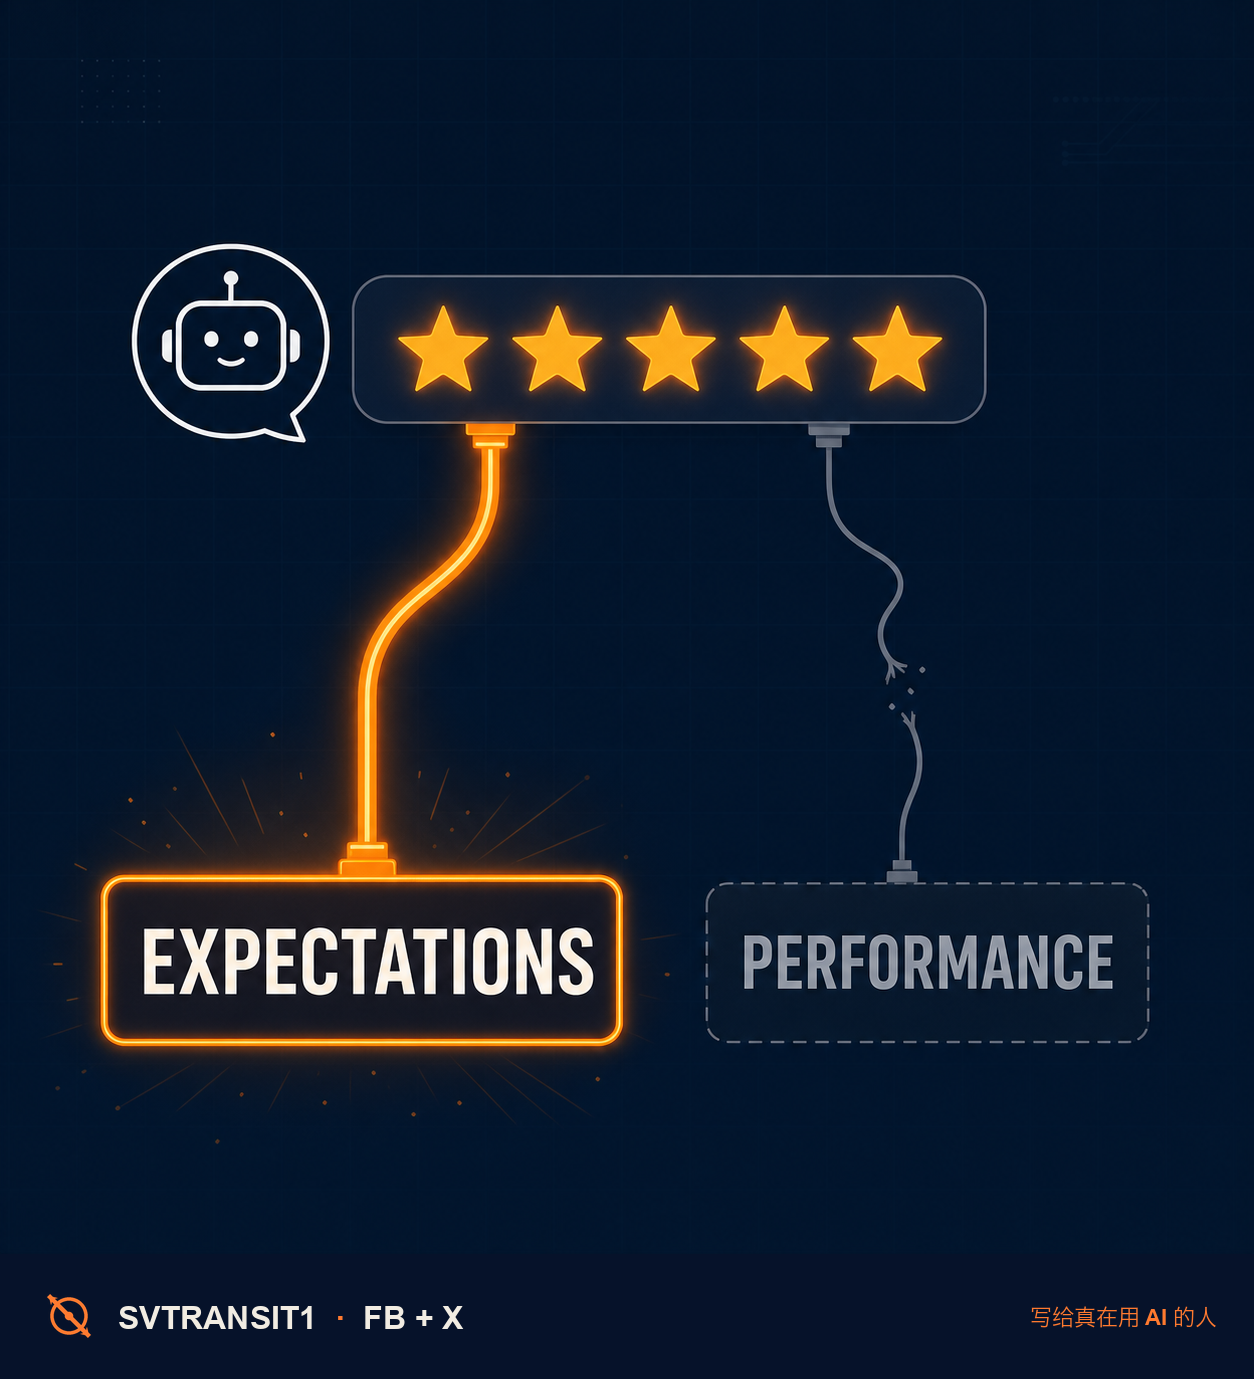
我们判断模型越来越靠「手感」:这个回答感觉更懂我、那个就是差点意思。有篇刚挂到 arXiv 的研究,标题起得很损——《Rating the Pitch, Not the Product》(评的是说辞,不是产品)——专门拆了这件事:找了 162 个人,用 6 个模型做 3 组协作任务,再看大家打的分到底跟着什么走。
结果挺扎心。模型任务表现的好坏,对用户评分几乎没有影响——那个系数 β 是 -0.01 和 0.11,基本等于零、不显著。真正把评分拉起来的是另外两件事:它有没有达到你进门前的预期(β 0.47、0.50),以及你用起来有多有信心、多舒服(β 0.47、0.36),两个都是 p 小于 0.001 的强相关。
说人话就是,真正决定分数的是它符不符合你事先的预期;它这次到底做得怎么样,反倒没那么占分量。交互结束后,用户打的还是进门时那套「说辞」的分,产品本身干得如何,反而靠边站。
对做产品、调 prompt、拿人的偏好做 A/B 的人,这是个提醒:你收上来的「更喜欢哪个」,一大半装的是你自己的预期和心理暗示。一个被吹得老高的模型,用户反而容易失望;先把预期压低的,随便发挥两下就「惊喜」了。你以为在测能力,量到的更多是包装。下次看到「我实测下来就是觉得 X 更强」这种话,不妨先想一句:他事先压的,是多高的预期?
当然别把一篇论文当铁律:样本就 162 人、只是协作任务上的主观偏好,不等于生产环境的真实表现;它也没说 benchmark 全没用,针对的是「让用户主观打分」这一类数据——里头预期的成分,重得超乎想象。而这恰恰是不少产品团队最爱用、也最信的一类信号。
转给那个天天「凭手感」夸模型的朋友。
原始出处 · 第一条评论拿
关注 @svtransit1 · 写给真在用 AI 的人
#AI #LLM #AI评测 #AI工具
原始来源:https://arxiv.org/abs/2607.05113
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS