
🤖 号称能自己干活的 AI agent,一拉进真实环境,连最强的 GPT-5 也只做对了 46%。
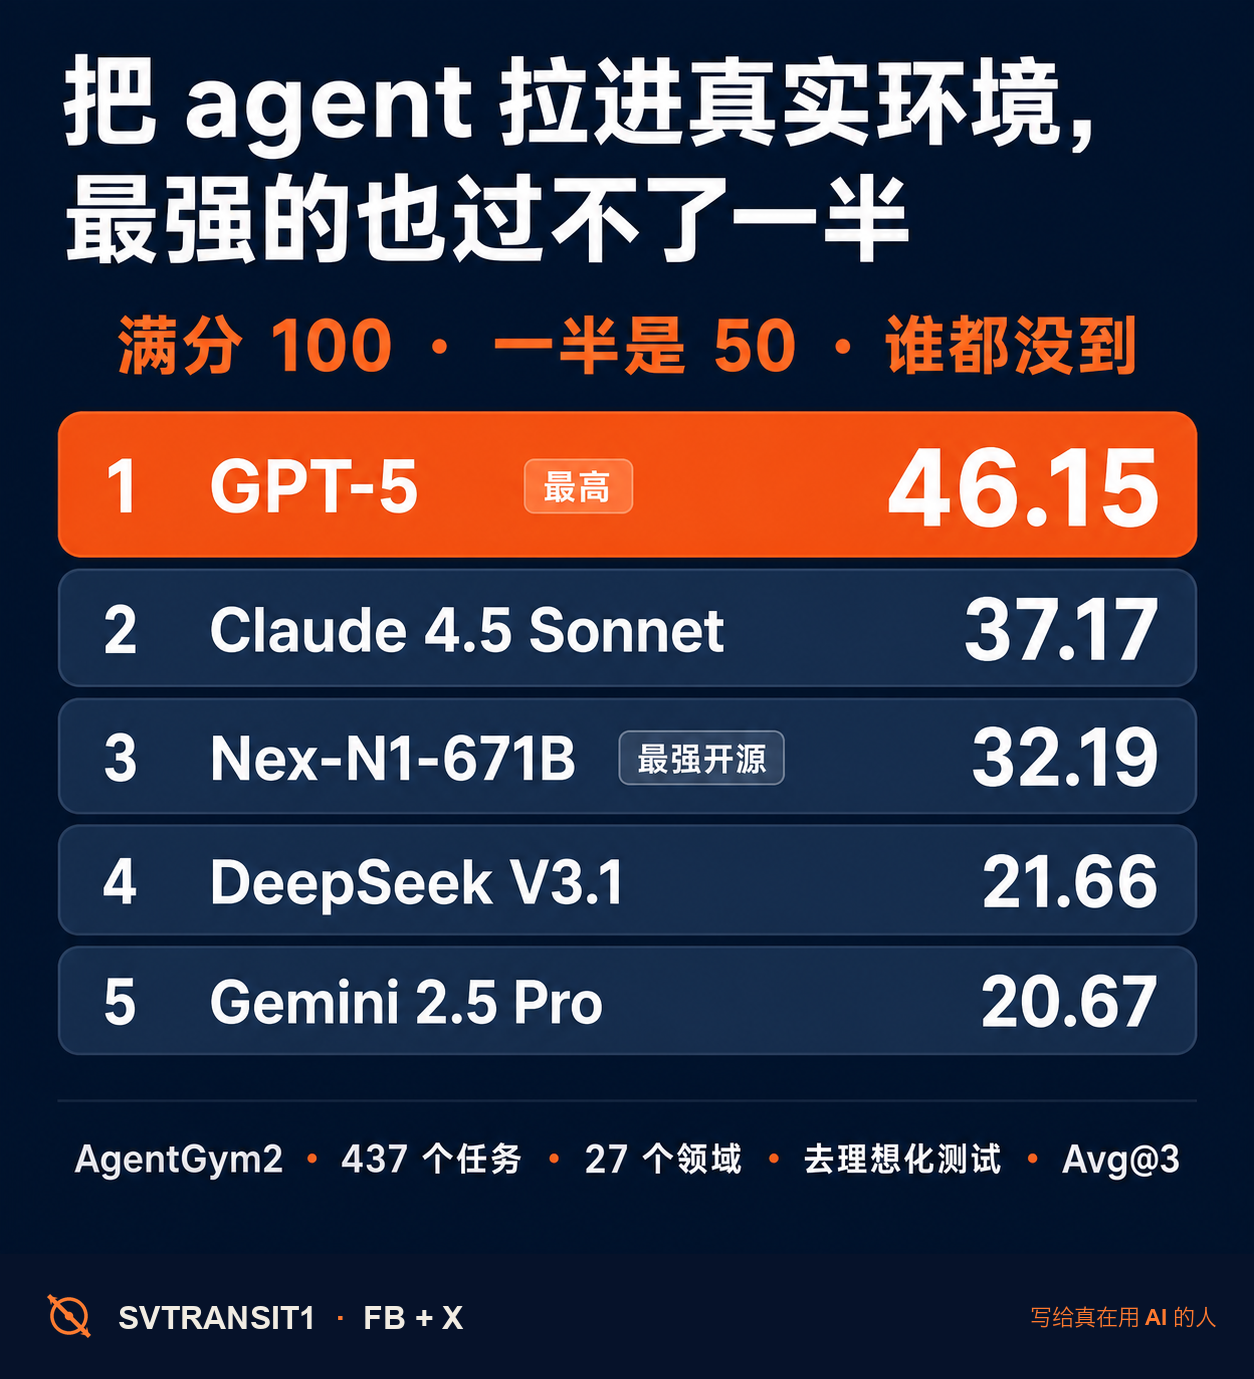
一篇新论文 AgentGym2(ACL 2026)做了件挺扫兴的事:把 agent 测试从「理想化」拉回「真实」。
🧪 平时的 benchmark,工具都替你摆好、输入干干净净。AgentGym2 反过来——agent 得自己探索、判断该用哪个工具,还得应付噪声和残缺的信息。437 个任务、27 个领域,尽量还原真实工作的样子。
📉 结果都在图里:最高的 GPT-5 也就 46.15,连一半都没过;Claude 4.5 Sonnet 37,最强开源 Nex-N1 32,Gemini 2.5 Pro 和 DeepSeek V3.1 都卡在 20 出头。论文的原话是:当前 agent 的能力,和真实应用的要求之间,还差着一大截。
所以下次看到「agent 又刷爆了某个榜」,先问一句:这个测试,替它把多少脏活累活提前擦干净了?
转给那个还在拿榜单分数吹 agent 有多强的人。
关注 @svtransit1 · 写给真在用 AI 的人
来源 · 评论区取 ↓
#AI #AIagent #GPT5 #Claude #AI日报
原始来源:https://arxiv.org/abs/2607.05174
关注 @svtransit1 · 每 3 小时一篇 AI 前线 · RSS